Poglavje 1 P1.1 Svetovni splet in celostni razvoj programske opreme
P1.1
1.1 Infrastrukturni in arhitekturni pogled na svetovni splet
Na svetu je približno 5 milijard internetnih uporabnikov, kar predstavlja okrog \(\boldsymbol{\frac{2}{3}}\) vseh prebivalcev na Zemlji1. Če upoštevamo vse naprave, ki so povezljive v internet, potem se ta številka po nekaterih ocenah giblje okrog 30 milijard naprav.
1.1.1 Moorov zakon
Vsaki 1 do 2 leti se računalniške kapacitete, ob nespremenjeni ceni, podvojijo. Takšen trend je identificiral Gordon Moore, soustanovitelj podjetja Intel. Moorov zakon lahko najdemo v kontekstu količine delovnega spomina, količine sekundarnega pomnilnika (npr. trdi disk), hitrosti procesorja, pasovne širine komunikacije idr.
Omenjen zakon resnično spodbuja informacijsko revolucijo, saj poleg področja IKT ni znano, da bi se na katerem drugem področju tehnologija tako hitro izpopolnjevala in hkrati stroški tako hitro padali.
1.1.2 Internet vs. (svetovni) splet
Internet je globalna mreža omrežij računalnikov in dejansko predstavlja omrežno infrastrukturo. Globalno povezuje ogromno količino računalnikov in tvori omrežje, kjer lahko poljuben računalnik komunicira s katerimkoli drugim računalnikom, če sta oba povezana v internet. Informacije, ki se prenašajo po internetu, so v različnih jezikih oz. protokolih.
Svetovni splet2 oz. poenostavljeno splet je način dostopa do informacij preko interneta, ki ga uporablja kot medij. Predstavlja model za izmenjavo informacij, ki temelji na internetu. Splet uporablja za prenos podatkov protokol HTTP, ki je zgolj eden izmed “jezikov”, prisotnih na internetu. Spletne storitve, ki uporabljajo HTTP za medsebojno komuniciranje poslovne logike, uporabljajo splet za izmenjavo informacij. Splet uporabljajo odjemalci, spletni brskalniki, kot so npr. Chrome, Safari, Firefox, Edge, Opera idr., za dostop do spletnih dokumentov oz. spletnih strani, ki so med seboj povezane preko spletnih povezav. Spletni dokumenti lahko vsebujejo grafiko, zvok, besedilo in video.
Splet je le eden od načinov izmenjave informacij preko interneta. Internet, ne splet, se uporablja tudi za elektronsko pošto, ki temelji na protokolu SMTP, takojšnje sporočanje, prenos datotek s protokolom FTP idr. Splet je le del interneta, čeprav predstavlja velik del njega, pa je potrebno izpostaviti, da pri teh pojmih ne gre za sinonima in jih ne smemo zamenjevati.
1.1.3 Razvoj interneta
V poznih letih 1960 je ARPA3 predstavila načrte za povezovanje osrednjega sistema računalnikov med določenimi univerzami in raziskovalnimi inštitucijami (glej sliko 1.1). Takratna hitrost povezave je bila 56 Kbps (56.000 bitov / sekundo), in sicer v času, ko je bila večina ljudi medsebojno povezanih s telefoni in hitrostjo okrog 110 bitov / sekundo. Organizacija ARPA je tako nadaljevala z implementacijo ARPANET, ki se je nato razvil v trenutni internet.
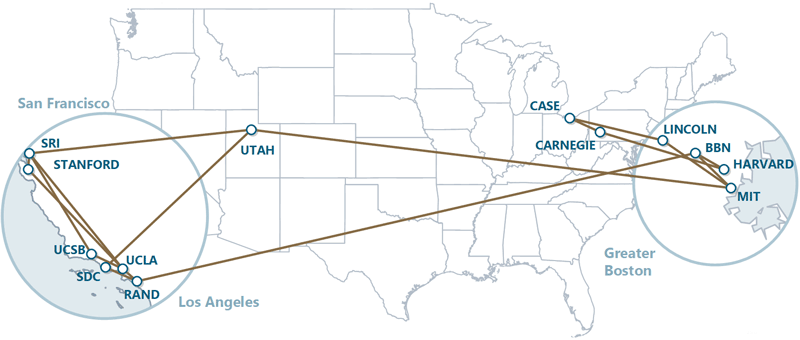
Slika 1.1: Začetek interneta v obliki ARPANET-a
Eden izmed ključnih ciljev ARPANET-a je bilo različnim uporabnikom istočasno omogočiti pošiljanje in prejemanje informacij preko istega komunikacijskega kanala (npr. telefonska linija). Omrežje se je obvladovalo s tehniko stikanja4, kjer se digitalni podatki pošljejo v majhnih svežnjih, imenovanih paketi. Paketi vsebujejo podatke o naslovu (pot do končne destinacije), podatke za nadzor napak in sekvenčne podatke (za razlikovanje med paketi zaradi uporabe kompleksnega usmerjevalnega mehanizma).
Protokol (poenostavljeno je to množica pravil) za komunikacijo preko ARPANET omrežja je znan pod imenom TCP5. Z vedno večjo priljubljenostjo je nastajalo tudi vedno večje število lastnih prilagojenih implementacij. Zaradi zagotavljanja medsebojne združljivosti je ARPA pripravila predlog IP6, kar dejansko predstavlja trenutno arhitekturo interneta. Skupina protokolov TCP/IP predstavlja omrežje računalnikov, kjer je vsak računalnik predstavljen z enoličnim IP naslovom. Od leta 1984 se še vedno uporablja IPv4 (pogosto v kombinaciji z NAT7), medtem ko je zaradi pomanjkanja števila prostih naslovov trenutno v uporabi tudi IPv6, ki prinaša tudi izboljšave na področju varnosti in sheme naslavljanja.
Najprej je bil internet omejen na uporabo s strani univerz in raziskovalnih inštitucij, nato pa so ga začeli uporabljati še v vojski, šele kasneje pa je bila dovoljena uporaba interneta za komercialne namene. Raziskovalna in vojaška skupnost je bila sprva v skrbeh, da se bo odzivni čas z večjim številom uporabnikov poslabšal, vendar se je zgodilo ravno nasprotno. Podjetja so začela velika vlaganja v izboljšavo interneta in v tej ostri konkurenci med različnimi akterji je posledično prišlo do neverjetne rasti pasovne širine (t.j. kapacitete prenosa podatkov) na internetu, kjer so stroški drastično padli.
1.1.4 Razvoj (svetovnega) spleta
Svetovni splet omogoča računalnikom na internetu izvajanje spletnih aplikacij in iskanje ter pregled dokumentov s poljubno vsebino. Leta 1989 je Tim Berners-Lee iz CERN-a začel z razvojem tehnologije za izmenjavo informacij s pomočjo dokumentov, ki so povezani s hiperpovezavami. Ta njegova novost se je imenovala HTML8, prav tako pa je pripravil komunikacijske protokole, ki so osnova svetovnega spleta. Najbolj pomembna sta komunikacijski protokol HTTP9 za pošiljanje informacij po spletu in URL10, ki opredeljuje naslov (t.j. lokacijo) spletne strani, prikazane v spletnem brskalniku. Vsaka spletna stran na internetu je povezana z enoličnim URL naslovom, ki se običajno začne s http://.
Prva spletna stran je bila objavljena 6. avgusta 1991, in sicer jo je izdelal Tim Berners-Lee. Ker prvotna stran ni več dosegljiva, so v CERN-u poiskali najstarejšo dostopno različico spletne strani iz leta 1992 (glej sliko 1.2), ki je dostopna na spletnem naslovu http://info.cern.ch/hypertext/WWW/TheProject.html.
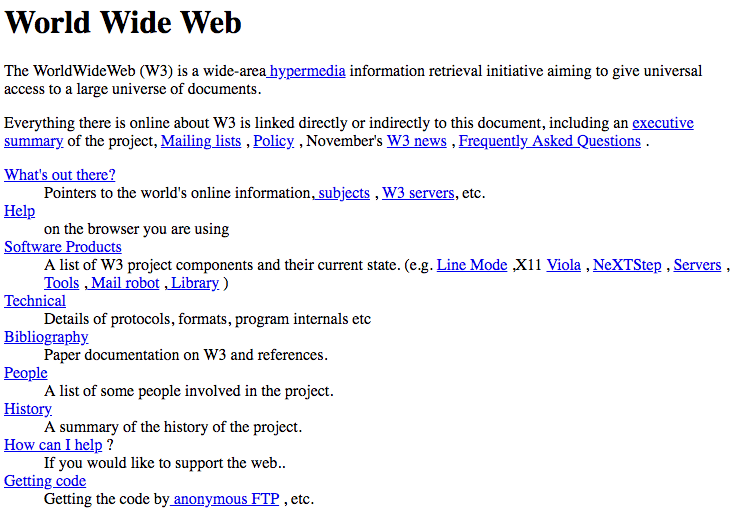
Slika 1.2: Najstarejša dostopna različica spletne strani iz leta 1992
URL naslovi spletnih strani, kjer se prenašajo zasebni podatki (npr. številke kreditnih kartic), se pogosto začnejo s https://, ki predstavlja HTTPS11 protokol in je standard za prenos šifriranih podatkov na spletu. Združuje HTTP in SSL12 protokola ter novejše TLS13 kriptografske sheme za varno komunikacijo in identifikacijo podatkov na spletu. Kljub temu da so številne prednosti uporabe protokola HTTPS, obstajajo tudi slabosti, kjer so mogoče najbolj izstopajoče težave z zmogljivostjo zaradi šifriranja in dešifriranja, ki zahtevata kar nekaj računalniških virov.
Uporaba svetovnega spleta se je eksponentno razširila leta 1993 z brskalnikom Mosaic, ki je že imel grafični uporabniški vmesnik. Razvojna ekipa, ki je sodelovala pri nastanku brskalnika Mosaic, je nato nadaljevala in ustanovila podjetje Netscape, ki je v času eksplozivne rasti internetne ekonomije v poznih 1990 odigralo ključno vlogo. Po “dot com” zlomu v letih 2000 se je stanje zopet začelo izboljševati nekje okrog leta 2004 z obdobjem, imenovanim Splet 2.0. Ključna internetna podjetja tega obdobja so Google, YouTube (souporaba video posnetkov), Facebook (družabno omrežje), Twitter (mikrobloganje), Groupon (družabno trgovanje), Foursquare (mobilna prijava), Salesforce (poslovna programska oprema v obliki storitev v oblaku), Craigslist, Flickr (souporaba slik), Skype (internetna telefonija in videoklici) in Wikipedia (brezplačna spletna enciklopedija).
1.1.5 Arhitektura odjemalec/strežnik
Osnovna interakcija na spletu je med odjemalcem (spletnim brskalnikom) in spletnim strežnikom. V najbolj preprosti obliki, je spletna stran zgolj enostaven HTML dokument (s končnico .html ali .htm), ki brskalniku opisuje vsebino in strukturo dokumenta.
HTML dokumenti v večini primerov vsebujejo spletne povezave oz. hiperpovezave, ki ob kliku zahtevajo nalaganje določenega spletnega dokumenta. S hiperpovezavo lahko referenciramo tako slike kot besedilo. Hiperpovezave se preprosto uporabljajo za referenciranje virov oz. strani, ki imajo o določeni problemski domeni na voljo več podatkov. Ravno s pomočjo hiperpovezav smo dosegli to eksponentno rast oz. učinek interneta.
Ob kliku uporabnika na spletno povezavo spletni strežnik poišče zahtevano spletno stran in jo posreduje uporabnikovemu spletnemu brskalniku. Podobno lahko uporabnik tudi neposredno vnese naslov spletne strani v brskalnikovo naslovno vrstico in zahteva prikaz.
Spletne povezave lahko referencirajo druge spletne strani, elektronske naslove (npr. mailto:elektronskiNaslov, kjer se ob kliku odpre privzeti program za pošiljanje elektronske pošte), datoteke (če brskalnik datoteke ne zna prikazati, jo preprosto prenese na lokalni računalnik) in mnoge druge.
URI14 je mehanizem za enolično identifikacijo virov na internetu. URI naslovi, ki se začnejo s http, se imenujejo URL15. Osnovna vloga URL-jev je referenciranje datotek, map ali programske kode na strežniku, ki izvaja funkcionalnosti poizvedovanja po podatkovni bazi, poizvedovanja po internetu in procesiranje v okviru poslovnih aplikacij. Če poznamo URL naslov javno dostopnega vira nekje na spletu, lahko z vnosom URL naslova v spletni brskalnik le-tega prikažemo.
URL vsebuje informacije, ki spletni brskalnik usmerijo na pravilno lokacijo za prikaz vira. Takšne vire uporabnikom omogočajo spletni strežniki (npr. Apache HTTP Server, Microsoft Internet Information Services, Nginx idr.).
Primer URL naslova je prikazan spodaj in v nadaljevanju bomo predstavili posamezne dele.
https://teaching.lavbic.net:443/SP/index.htmlZgornji primer URL naslova se začne z besedilom https://, ki nam pove, da se naj za dostop do vira uporabi HTTPS protokol. Naslednji podatek URL naslova je ime gostitelja16 (npr. teaching.lavbic.net), ki predstavlja računalnik, na katerem je nameščen spletni strežnik za strežbo zahtevanega vira. Ime gostitelja teaching.lavbic.net se nato prevede v IP naslov (numerična vrednost, ki enolično določa strežnik na internetu). Za to funkcionalnost se uporabi DNS17 strežnik, ki vsebuje preslikovalne tabele imen gostiteljev in njihovih IP naslovov ter transformacijo izvede samodejno. Nato sledijo opcijska (če niso privzeta) vrata18, ki nam povedo, kje strežnik posluša za zahteve. V našem primeru je številka vrat 443, kar je privzeta vrednost za HTTPS protokol, medtem ko so vrata 80 privzeta za protokol HTTP. Preostanek URL naslova /SP/index.html predstavlja lokacijo /SP in ime vira index.html na spletnem strežniku. Naslov vira lahko predstavlja dejansko mapo na datotečnem sistemu spletnega strežnika, vendar zaradi varnostnih razlogov je lokacija vira po navadi virtualna mapa oz. naslov. Spletni strežnik nato pretvori virtualno mapo v dejansko lokacijo na strežniku in na ta način prikrije dejansko lokacijo vira.
1.1.5.1 Posredovanje zahteve in prejem odgovora
Ko ima uporabnik na voljo URL naslov spletne strani, njegov spletni brskalnik s pomočjo HTTP protokola posreduje zahtevo spletnemu strežniku, kot je to prikazano na sliki 1.3.
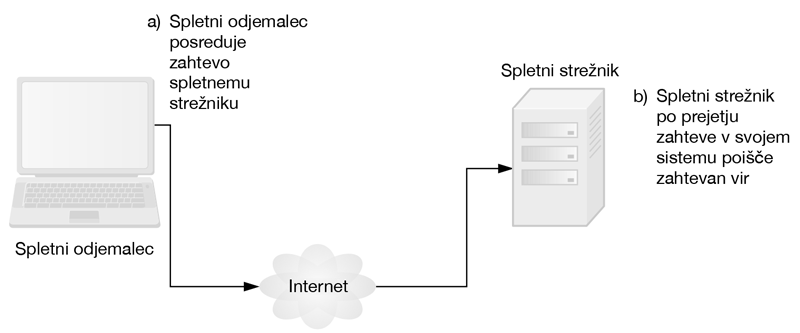
Slika 1.3: Spletni odjemalec zahteva vir na spletnem strežniku
Zahteva v našem enostavnem primeru je naslednje oblike:
GET /SP/index.html HTTP/1.1Beseda GET predstavlja HTTP metodo, s katero zahtevamo vir na spletnem strežniku. Preostanek zahteve predstavlja pot do vira (npr. HTML5 dokument) ter ime protokola in njegova verzija (HTTP/1.1). V zahtevo lahko vključimo tudi obvezne in opcijske podatke v glavi19.
Vsak strežnik, ki razume HTTP protokol (v našem primeru verzijo 1.1), lahko sprocesira zahtevo in odgovor, kot je prikazano na sliki 1.4.
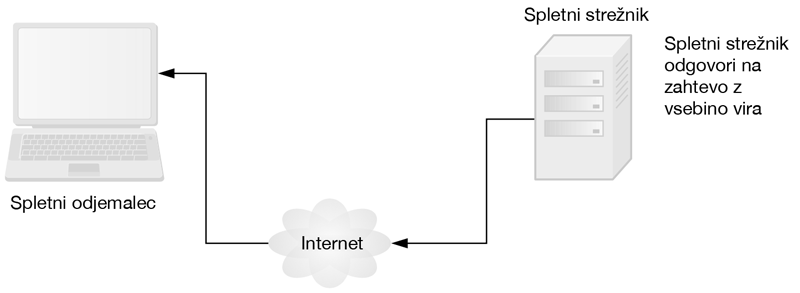
Slika 1.4: Spletni odjemalec dobi odgovor od spletnega strežnika
Strežnik nato odgovori odjemalcu z vrstico besedila, ki vsebuje verzijo protokola in numerično kodo ter rezervirano besedo za opis statusa zahteve. V primeru uspešnega statusa je primer odgovora naslednji:
HTTP/1.1 200 OKče pa pride do napake (npr. vira ni mogoče najti), je primer odgovora spodaj:
HTTP/1.1 404 Not foundCeloten seznam numeričnih kod, ki predstavljajo HTTP status transakcije, je na voljo na (W3C 1999).
V nadaljevanju strežnik posreduje eno ali več glav HTTP za dodaten opis podatkov. V našem primeru strežnik posreduje HTML5 tekstovni dokument, zato bi bila glava HTTP v našem primeru naslednja:
Content-type: text/htmlPodatke v tej glavi HTTP opredeljuje tip MIME20, ki nam pove, kakšnega tipa je vsebina, ki jo strežnik posreduje kot odgovor odjemalcu. MIME standard opredeljuje podatkovne formate, ki so v pomoč programom pri pravilni interpretaciji vsebine. Npr. tip MIME text/plain daje brskalniku navodilo, naj vsebino interpretira kot navadno besedilo in ga preprosto prikaže. Podobno tip MIME image/jpeg predstavlja vsebino, ki predstavlja sliko v JPEG formatu. Brskalnik ob prejemu takšne vsebine le-to prikaže kot sliko. Po posredovanju enega ali več tipov MIME sledi prazna vrstica, kar je potrditev, da ni več tipov MIME in bo sledila vsebina zahtevanega dokumenta (npr. index.html). Brskalnik na strani odjemalca nato prikaže dokument, ki lahko vsebuje še več dodatnih zahtev za pridobitev povezanih stilov CSS in slik.
Najbolj pogosti HTTP metodi oz. tipa zahtev HTTP sta GET in POST. Z GET metodo zahtevamo informacije s strani strežnika, kot je npr. HTML dokument, slika ali rezultati iskanja na podlagi uporabniške poizvedbe preko spletnega obrazca. S POST metodo posredujemo podatke na strežnik in se večinoma uporablja pri pošiljanju podatkov spletnega obrazca. Za posredovanje podatkov na strežnik lahko uporabimo tako GET kot POST metodo, vendar je način posredovanja podatkov pri vsaki izmed metod drugačen.
Pri GET metodi podatke dodamo kot del URL naslova, npr. www.google.com/search?q=SP. V tem primeru je search ime funkcionalnosti na strani Google strežnikov, ki sprejema iskalne zahteve, q je ime spremenljivke v spletnem obrazcu in SP ključna beseda iskanja. Znak ? v URL zahtevi loči poizvedovalni niz od preostanka URL naslova v zahtevi. Par ime/vrednost se posreduje na strežnik, kjer sta ime in vrednost ločena z znakom =. Če želimo vključiti več parov ime/vrednost, potem pare med seboj ločimo z znakom &. Strežnik prejme posredovane podatke s strani odjemalca, jih razčleni, s tem pridobi ustrezen vir na strežniku in ga posreduje v odgovoru nazaj odjemalcu.
Pri POST zahtevi se podatki posredujejo kot del sporočila HTTP in ne kot del URL naslova. GET zahteva je po navadi tudi omejena z dolžino poizvedovalnega niza (t.j. dolžina niza desno od znaka ?), tako da je potrebno, v primeru pošiljanja večje količine podatkov, le-te posredovati s POST metodo. Prav tako uporabljamo POST metodo takrat, ko želimo določene podatke uporabniku skriti, tako da jih samodejno vključimo v sporočilo HTTP. V primeru spletnih obrazcev imamo to funkcionalnost podprto v obliki skritih polj, ki se ob pošiljanju potem tudi posredujejo na strežnik.
Namig: Podatki, poslani s pomočjo
POSTmetode, niso del URL naslova, zato jih uporabnik privzeto ne vidi. Kljub temu so na voljo orodja, ki nam omogočajo prikaz teh podatkov, zato ne smemo predvidevati, da so poslani podatki varni pred zlorabo samo zato, če uporabimoPOSTzahtevo.
Spletni brskalniki pogosto predpomnijo21 zadnje prikazane spletne strani, zaradi hitrejšega ponovnega prikaza. Če med zadnjim ogledom strani ni bilo nobene spremembe na strežniku, potem to zagotovo izboljša uporabniško izkušnjo. Pri posredovanju HTTP odgovora imamo možnost opredeliti čas, za katerega se smatra, da je vsebina še vedno aktualna. Če ta čas še ni pretekel, potem spletni brskalnik ne bo izvedel dostopa do strežnika in bo preprosto prikazal lokalno kopijo. Po navadi spletni brskalniki ne predpomnijo POST zahtev, saj pogosto vsaka naslednja takšna zahteva vrača drugačen odgovor.
1.1.6 Večnivojska arhitektura
Spletne aplikacije so pogosto zgrajene v obliki večnivojske arhitekture22 in jih imenujemo tudi n-nivojske aplikacije, saj so funkcionalnosti porazdeljene v različne ravni (t.j. logično združene funkcionalnosti). Kljub temu, da so lahko posamezne ravni nameščene na istem računalniku, jih po navadi porazdelimo po različnih računalnikih. Slika 1.5 prikazuje osnovno zgradbo 3-nivojske arhitekture spletne aplikacije.
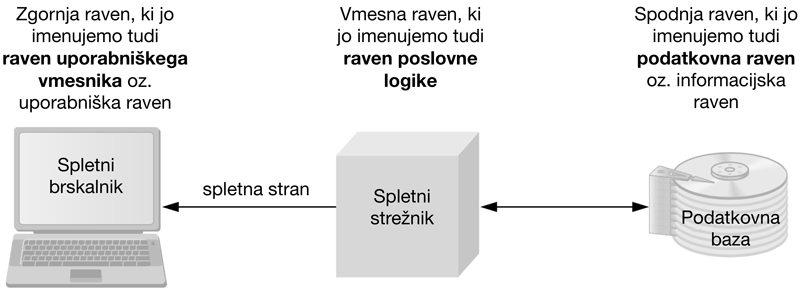
Slika 1.5: 3-nivojska arhitektura
Spodnjo raven poznamo tudi pod imenom raven podatkovne baze oz. informacijska raven, ki skrbi za trajno hrambo podatkov aplikacije. Na tej ravni so podatki po navadi shranjeni v relacijski ali NoSQL podatkovni bazi. Npr. pri podjetju Amazon bi to lahko bili podatki o zalogah izdelkov, ki jih prodajajo, opisi, cene izdelkov idr.
Vmesna raven implementira poslovno logiko, ki skrbi za interakcijo med odjemalci aplikacije in podatki aplikacije. Vmesna raven je tudi povezovalni člen med zgornjo ravnjo uporabniškega vmesnika in spodnjo podatkovno ravnjo. Kontrolna logika vmesne ravni skrbi za procesiranje zahtev odjemalcev (kot je npr. zahteva za prikaz seznama izdelkov) in pridobi podatke iz podatkovne baze. Predstavitvena logika vmesne ravni pa sprocesira podatke iz podatkovne ravni ter vsebino predstavi odjemalcu. Spletne aplikacije po navadi podatke odjemalcem predstavijo v obliki HTML dokumentov. Poslovna logika vmesne ravni uporablja poslovna pravila in zagotavlja, da so podatki zanesljivi, preden jih trajno shrani v podatkovno bazo ali prikaže uporabniku. Primer poslovnega pravila pri spletni trgovini bi lahko bil, da moramo vedno zagotoviti pozitivno količino izdelkov na zalogi.
Zgornja raven oz. raven uporabniškega vmesnika skrbi za pridobivanje uporabniškega vnosa in prikaz rezultatov. Uporabniki aplikacijo interaktivno uporabljajo preko uporabniškega vmesnika, ki je po navadi spletni brskalnik oz. mobilna naprava. Kot odgovor uporabnikovim zahtevam (npr. klik na spletno povezavo) raven uporabniškega vmesnika kontaktira vmesno raven in zahteva pridobitev podatkov iz podatkovne ravni. Odjemalec po uspešnem odgovoru prikaže podatke uporabniku.
1.1.7 Pomembni mejniki in akterji
Leta 1994 je Tim Berners-Lee ustanovil organizacijo World Wide Web Consortium (W3C), ki skrbi za razvoj nelastniških in interoperabilnih tehnologij za svetovni splet. Eden izmed ključnih ciljev organizacije W3C je omogočiti univerzalen dostop do spleta, ne glede na določene človeške nezmožnosti, jezik ali kulturo. W3C organizacija skrbi tudi za standarde - standardizirane in potrjene tehnologije s strani W3C se imenujejo priporočila23, npr. HTML5 (W3C 2014), CSS3 (W3C 2017), XML (W3C 2008) idr. Priporočilo ni dejanski program, ampak dokument, ki opredeljuje specifično tehnologijo z vidika njene vloge, pravil sintakse ipd.
Pomemben preskok v načinu uporabe svetovnega spleta in razvoju spletnih aplikacij se je zgodil leta 2003, ko je Dale Dougherty iz O’Reilly Media opisal trend, imenovan Splet 2.024. V tem obdobju so podjetja začela splet uporabljati kot platformo za razvoj strani, ki temeljijo na sodelovanju in soudeležbi večje skupnosti (npr. družabna omrežja, blogi, wiki ipd.). Splet 1.025 (stanje spleta med leti 1990 in začetkom 2000) se je osredotočal na relativno majhno število podjetij in oglaševalcev, ki so vsebino večinoma prikazovali v obliki katalogov izdelkov, storitev ipd.. Splet 2.0 pa vključuje uporabnika - ne samo da sodelujejo pri sooblikovanju vsebine, ampak jo tudi pomagajo organizirati, deliti, kritizirati, posodobiti itd. Splet 1.0 si lahko predstavljamo kot predavanja, kjer majhno število profesorjev predava večjemu številu študentov. V nasprotju s Spletom 2.0, kjer pa gre za pogovor, kjer imajo vsi priložnost izraziti svoje mnenje in poglede. Podjetja, ki razumejo koncept Spleta 2.0, so spoznala, da so tudi njihovi izdelki in storitve analogni takšnim pogovorom.
Splet 2.0 ponuja nove priložnosti pri povezovanju ljudi in vsebine, saj temelji na arhitekturi sodelovanja - pristop, ki spodbuja uporabnike k interakciji in doprinosu k skupnosti. Številni priljubljeni blogerji sedaj že tekmujejo z uspešnimi medijskimi hišami in številna podjetja Spleta 2.0 temeljijo zgolj na uporabniško generirani vsebini. Pri spletnih straneh kot so Facebook, Twitter, YouTube, eBay in Wikipedia, uporabniki prispevajo vsebino, medtem ko podjetja skrbijo za platformo, kjer se lahko ti uporabniki srečajo in delijo informacije. Arhitektura sodelovanja je vplivala tudi na razvoj programske opreme. Odprtokodna programska oprema je na voljo za vsakogar, kjer si jo lahko prilagodimo za lastne potrebe z manjšimi ali celo brez omejitev. S pomočjo skupinske inteligence26, kjer večja in raznolika skupina uporabnikov skupaj razvije napredno idejo, večje skupnosti razvijalcev sodelujejo pri razvoju programske opreme in obstaja prepričanje, da tako nastane boljša in bolj robustna informacijska rešitev.
Spletni iskalniki (npr. Google, Microsoft Bing idr.) so v tem času nepogrešljivi pomočniki pri iskanju med ogromno množico podatkov na svetovnem spletu.
Spletne storitve27 in prepletene storitve28 so zelo pomemben vidik razvoja spletnih aplikacij, kateremu bomo tudi v okviru tega tečaja namenili veliko pozornosti. Pri prepletenih storitvah gre namreč za hiter razvoj aplikacij z združevanjem (pogosto prosto dostopnih) spletnih storitev in ostalih oblik podatkov (glej tabelo 1.1).
| Spletna storitev | Namen uporabe |
|---|---|
| Google Maps | geografska storitev |
| družabno omrežje za mikroblogiranje | |
| YouTube | video posnetki |
| Flickr | fotografije |
| družabno omrežje |
AJAX29 je ena izmed ključnih tehnologij obdobja Spleta 2.0, saj predvsem pomaga pri izboljšanju uporabniške izkušnje tako, da dobimo pri uporabi spletne aplikacije občutek, kot da uporabljamo namizno aplikacijo.
V prihodnje se predvideva, da bodo računalniki sposobni učenja pomena podatkov na spletu in zametke semantičnega spleta30 lahko opazimo že danes. Splet 3.031 je naslednja iteracija svetovnega spleta, ki jo je opredelili Tim Berners-Lee, kjer je semantični splet eden izmed osrednjih gradnikov. Cilj Spleta 3.0 je narediti podatke na internetu strojno berljive, kjer se uporabljajo tehnologije kot so Resource Description Framework (RDF), Web Ontology Language (OWL) idr. Splet 3.0 naj bi bil splet podatkov32, ki ga je možno strojno obdelovati, saj je velik del pomena zapisanega v strojni obliki.
Pojavila pa se je tudi drugačna opredelitev naslednje iteracije spleta, in sicer Splet333, ki pa temelji na decentraliziranosti, tehnologijah veriženja blokov in ekonomiji na osnovi žetonov. Omenjeno opredelitev Spleta3 je podal Gavin Wood, soustanovitelj verig blokov Ethereum in Polkadot.
1.1.8 Trenutno stanje na trgu
1.1.8.1 Spletni odjemalci - brskalniki
Trenutno je na trgu veliko število spletnih brskalnikov, medtem ko je kronološki vrstni red pojavitve najpomembnejših naslednji:
- WorldWideWeb (25. februar 1990),
- Mosaic (22. april 1993),
- Netscape Navigator in Netscape Communicator (13. oktober 1994),
- Internet Explorer (16. avgust 1995),
- Opera (1996),
- Mozilla Navigator (5. junij 2002),
- Safari (7. januar 2003),
- Mozilla Firefox (9. november 2004),
- Google Chrome (2. september 2008),
- Microsoft Edge (29. julij 2015).
Kakovost podpore standardu HTML5 je prikazana na sliki 1.6, kjer so vključeni najbolj priljubljeni iskalniki (Chrome, Edge, Firefox, Opera in Safari) in njihova podpora standardu HTML5 skozi čas. Opazimo lahko, da standardu HTML5 najbolj sledita brskalnika Chrome in Opera.
](assets/img/HTML5_test_score_over_the_years_2022_09_20.png)
Slika 1.6: Primerjava podprtih funkcionalnosti najbolj uporabljanih brskalnikov glede na HTML5test
Zanimiv pregled tržnega deleža različnih naprav (mobilnih, tabličnih in namiznih), ki dostopajo do spleta, je prikazan na sliki 1.7. Razviden je trend rasti deleža mobilnih naprav, ki je proti koncu leta 2016 prehitel delež namiznih naprav, v zadnjem obdobju pa sta se izmenjevala v vodstvu, kjer se ponovno kaže naraščajoči trend mobilnih naprav.
](assets/img/Desktop_vs_Mobile_vs_Tablet_Market_Share_Worldwide_2009_01_2023_08.png)
Slika 1.7: Tržni delež namiznih, mobilnih in tabličnih naprav na StatCounter
Slika 1.8 prikazuje tržni delež spletnih brskalnikov, kjer z veliko prednostjo vodi brskalnik Chrome, kar je tudi pričakovano glede na njegovo največjo skladnost s spletnimi standardi, kot prikazuje slika 1.6.
](assets/img/Browser_Market_Share_Worldwide_2009_01_2023_08.png)
Slika 1.8: Tržni delež spletnih brskalnikov na HTML5test
1.1.8.2 Spletni strežniki
Trenutno je na trgu veliko število spletnih strežnikov, kjer vodilnim dvema (nginx in Apache) pripada okrog \(39\ \%\) tržnega deleža, kot je prikazano na sliki 1.9, kjer je za metriko priljubljenosti uporabljeno število aktivnih spletnih strani. Največji delež aktivnih spletnih strani streže spletni strežnik Apache, in sicer \(20\ \%\). Na drugem mestu je nginx, ki trenutno poganja \(19\ \%\) aktivnih spletnih strani.
](assets/img/Web_server_developers_Market_share_of_active_sites.png)
Slika 1.9: Tržni delež aktivnih spletnih strani po spletnih strežnikih na Netcraft
1.2 Uporabljen pristop pri tečajih
Cilj tečajev Web development (backend in frontend) je predstaviti razvoj kompleksne spletne aplikacije na izbranih tehnologijah, ki so trenutno v uporabi. Razvoja spletne aplikacije se bomo lotili celostno, kar pomeni, da jo bomo razvili od začetka do produkcijske različice, ki jo bomo tudi javno gostili na spletnem strežniku. V okviru predavanj bodo predstavljeni posamezni koraki razvoja spletne aplikacije, medtem ko boste morali udeleženci v okviru vaj in dela doma implementirati lasten projekt. Pri tečaju bomo spoznali naslednje ključne mejnike pri razvoju kompleksne spletne aplikacije:
- načrtovanje aplikacije z wireframe modelom in medsebojne odvisnosti med zasloni uporabniškega vmesnika,
- razvoj statične aplikacije z vnaprej opredeljenimi testnimi podatki,
- povezovanje s podatkovno bazo in vključitev dinamičnih podatkov,
- dodajanje interaktivnosti na uporabniški vmesnik,
- razvoj SPA spletne aplikacije na eni strani,
- dodajanje varnostnih mehanizmov za dostop do aplikacije,
- preoblikovanje obstoječe aplikacije v progresivno spletno aplikacijo PWA.
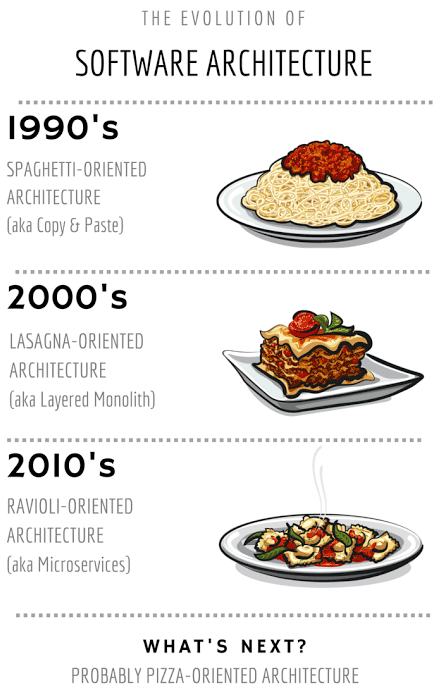
Slika 1.10: Razvoj različnih pristopov k razvoju informacijskih sistemov (Hediard 2015)
Slika 1.10 poenostavljeno prikazuje razvoj arhitekture programskih rešitev skozi čas na analognih primerih iz sveta kulinarike. Takšen je po navadi tudi učni proces pri razvijalcih programske opreme, kjer na začetku preprosto razvijemo programsko rešitev in pri tem uporabimo kakšno dobro prakso (kopiraj/prilepi pristop) in vse skupaj sestavimo v delujočo rešitev. Kasneje, ko postanemo bolj izkušeni, rešitev razdelimo v več ravni (npr. podatkovna baza, aplikacijski strežnik in uporabniški vmesnik). Z omenjenim pristopom bomo začeli tudi mi v okviru teh predavanj. Kasneje pa ugotovimo, da bi bilo mogoče smiselno pripraviti več različnih odjemalcev, ki dostopajo do istega nabora podatkov in ponujajo podobne ali različne funkcionalnosti. Na ta način začnemo razmišljati o mikrostoritvah, kjer bomo v okviru tečaja razvili REST API dostop do podatkovne baze in tako omogočili razvoj različnih aplikacij nad isto problemsko domeno.
1.2.1 Tehnologije, ki jih bomo uporabljali
Pri razvoju spletnih aplikacij bomo stremeli k uporabi čim manjšega števila programskih jezikov in pristopov, kar je pogosto težko, saj vedno znova in znova nastajajo nova ogrodja in knjižnice, ki na nek način izboljšajo uporabniško izkušnjo spletnih aplikacij. V okviru tega tečaja bo razvoj temeljil na programskem jeziku interneta - JavaScript.
JavaScript, kot programski jezik, je v svetu spletnih aplikacij prisoten tako na strani odjemalca (spletni brskalnik), kot tudi strežnika (Node.js) (Delgado 2017). V zadnjem času ga vedno bolj uporabljajo tudi na strani strežnika, tudi s strani velikih podjetij, kot je Netflix (pretvorba obstoječih strani v SPA), PayPal (prehod iz Java na Node.js), Uber (celoten sistem v Node.js), IBM (regresijski testi v Node.js), Microsoft (neposredna integracija v Azure) idr.
Zagotovo JavaScript na strani strežnika (Node.js) ni vedno primeren za uporabo (npr. procesorsko zahtevna opravila, enostavne CRUD34 operacije, brez potrebe po API-ju), medtem ko pa obstaja kar nekaj scenarijev, ki so zelo primerni za uporabo Node.js (npr. aplikacije v realnem času, hitro in skalabilno okolje idr.) (Rachowicz 2017).
JavaScript na strani odjemalca in Node.js na strani strežnika je po številnih raziskavah (Hecht 2017) zelo primerna kombinacija za celostni razvoj spletnih aplikacij in takšen pristop bomo uporabili tudi pri tem tečaju. Rast priljubljenosti jezika JavaScript je omenjena tudi v spletnih trendih za leto 2017 (Budko 2017).
JavaScript, kot programski jezik, pa pridobiva na priljubljenosti tudi kot začetni programski jezik, s katerim se študenti srečajo prvič. Celo na eni izmed najboljših univerz na svetu Stanford University so se odločili za zamenjavo Java programskega jezika s programskim jezikom JavaScript, s preprosto obrazložitvijo, da gre za jezik interneta (Smit 2017).
Poleg osrednjega programskega jezika JavaScript bomo pri tečaju uporabljali naslednji sklad tehnologij in pristopov:
- Git je porazdeljen sistem za obvladovanje verzij in Github je implementacija takšnega sistema v oblaku,
- HTML je standardni označevalni jezik za izdelavo spletnih strani.
- CSS so prekrivni slogi, ki na enostaven način omogočajo dodajanja stila (npr. pisava, barve, velikost idr.) spletnim dokumentom.
- JavaScript (Node.js) je programski jezik za razvoj spletnih informacijskih rešitev na strani odjemalca in strežnika,
- TypeScript je tipizirana oblika jezika JavaScript, ki jo lahko prevedemo v osnovno obliko jezika JavaScript.
- Bootstrap je knjižnica za razvoj prilagodljivega spletnega uporabniškega vmesnika, primernega za več vrst naprav (npr. namizni računalnik, tablica, mobilni telefon ipd.),
- Nodemon je pripomoček za razvoj v okolju Node.js, spremlja izvorno kodo in ob spremembi samodejno ponovno zažene strežnik,
- Express je Node.js ogrodje za razvoj spletnih aplikacij in podpira tudi MVC arhitekturni slog,
- Handlebars je okolje za obvladovanje HTML predlog, ki omogočajo avtomatizirano generiranje spletnih strani,
- MongoDB je dokumentno usmerjena NoSQL podatkovna baza,
- Mongoose je ODM (Object Document Mapper), ki nam olajša delo s podatkovno bazo MongoDB s preslikavo dokumentov v objekte.
- Angular je strukturirano ogrodje za razvoj dinamičnih spletnih aplikacij in spada v skupino MVW (Model-View-Whatever works for you),
- MongoDB Atlas je ponudnik MongoDB podatkovne baze v oblaku (Database-as-a-Service).
1.3 Celostni razvoj programske opreme z MEAN arhitekturo
O celostnem razvoju programske opreme35 govorimo, ko razvijemo vse dele spletne aplikacije, ki se začne s podatkovno bazo in spletnim strežnikom na zalednem delu36, poslovno logiko na vmesnem sloju in uporabniškim vmesnikom na zgornji ravni, kot je prikazano na sliki 1.5.
Pri razvoju se bomo osredotočili na MEAN arhitekturo, ki jo sestavljajo 4 ključne tehnologije:
- MongoDB je dokumentno usmerjena NoSQL podatkovna baza (MongoDB Inc. 2007),
- Express je Node.js ogrodje za razvoj spletnih aplikacij in podpira tudi MVC arhitekturni slog (Node.js Foundation 2009a),
- Angular je strukturirano ogrodje za razvoj dinamičnih spletnih aplikacij in spada v skupino MVW (Model-View-Whatever works for you) (Google 2019),
- Node.js je zagonsko okolje, ki izvaja JavaScript kodo izven brskalnika (Node.js Foundation 2009b).
Na začetku razvoja spletnih aplikacij uporabniki niso imeli veliko pričakovanj od spletnih strani. Sami predstavitvi se ni posvečalo veliko pozornosti, ampak je bil večji poudarek na zalednem delu sistema. Če si v tem začetnem obdobju poznal jezika Perl in HTML, potem si bil spletni razvijalec.
Z vedno večjo popularizacijo interneta pa so podjetja začela vedno večji poudarek dajati tudi na uporabniški vmesnik. Pojavili so se prekrivni slogi (CSS) in jezik JavaScript, kar je pripeljalo do bolj kompleksnih uporabniških vmesnikov. Poleg tega je bilo potrebno končno rešitev preveriti tudi v različnih brskalnikih, ki so bili včasih bolj nezdružljivi kot danes. In v tem trenutku se je začela ločevati vloga razvijalcev čelnega dela sistema in razvijalcev zalednega dela sistema, kot to prikazuje slika 1.11. Razvijalci zalednega dela sistema so se osredotočali na delovanje strežnika, medtem ko so se razvijalci čelnega dela sistema ukvarjali z izboljšanjem uporabniške izkušnje.
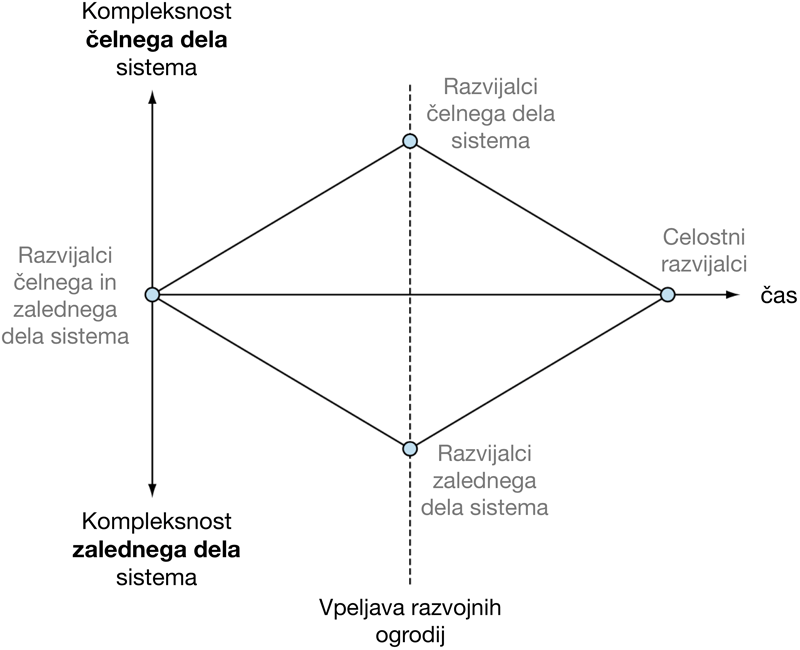
Slika 1.11: Vpliv vpeljave razvojnih ogrodij na delitev razvijalcev čelnega in zalednega dela sistema ter pozicioniranje celostnih razvijalcev programske opreme
Okrog leta 2000 so se začele pojavljati številne knjižnice in ogrodja za različne programske jezike, tako na strani odjemalca kot na strani strežnika (npr. Dojo in jQuery za JavaScript, CodeIgniter za PHP in Ruby on Rails idr.). Dobra knjižnica oz. ogrodje olajša delo programerja in odstrani določene kompleksnosti razvoja, kar posledično pomeni krajši čas razvoja in nižjo raven potrebne ekspertize. Ta trend poenostavljanja razvoja je pripeljal do celostnih razvijalcev (prikazani na sliki 1.11), ki razvijajo čelni in zaledni del sistema. Velika prednost celostnih razvijalcev je zagotovo uporaba izbranega ogrodja, kar omogoča predvsem večjo produktivnost.
V zadnjem času prihaja do trenda, kjer aplikacijsko kodo počasi premikamo po ravneh navzgor proti ravni uporabniškega vmesnika. Eden izmed razlogov je zmanjšanje obremenitve strežnika in s tem tudi zmanjšanje stroškov za vzdrževanje. Dejansko se v tem primeru izvaja množičenje37 računske moči, saj se del izvajanja aplikacije prenaša na uporabnikove spletne brskalnike.
Obstajajo številne prednosti celostnega razvoja programske opreme, od zadovoljstva učenja novih stvari, igranja z novimi tehnologijami, zadovoljstva ob zavedanju, da ste samostojno sposobni zgraditi in pognati polno delujočo spletno aplikacijo, ki se povezuje s podatkovno bazo. Ključna prednost celostnega razvoja programske opreme pa je zagotovo sposobnost pregleda nad celotnim problemom, ki ga, če delujemo v večji ekipi, ki je ne vodimo, nimamo.
V okviru tečaja se bomo celostnega razvoja programske opreme lotili s pomočjo MEAN arhitekture, ki združuje moderne spletne tehnologije v zelo učinkovitem in prilagodljivem skladu. Zagotovo ena izmed bolj izstopajočih prednosti je uporaba jezika JavaScript na več ravneh, tj. na strani odjemalca, kot tudi na strani strežnika. Osrednja tehnologija, ki nam to omogoča, je Node.js, ki podpira izvajanje jezika JavaScript na strani strežnika.
1.3.1 Node.js
Node.js predstavlja v MEAN arhitekturi črko N. Poenostavljeno povedano, je Node.js platforma za razvoj programske opreme, kjer lahko kreiramo svoj lasten spletni strežnik in na njem zgradimo spletno aplikacijo. Node.js sam po sebi ni spletni strežnik, niti jezik. Vsebuje sicer vgrajene knjižnice za izgradnjo HTTP strežnika, tako da ni potrebe po zaganjanju ločenega programa za strežbo spletnih strani (kot je to npr. Apache ali Internet Information Services (IIS)). Na ta način imamo večji nadzor nad delovanjem spletnega strežnika, po drugi strani pa se poveča kompleksnost pri postavljanju in izvajanju še posebej v produkcijskem okolju.
Eden izmed ključnih razlogov za vedno večjo popularnost Node.js je dejstvo, da lahko razvijate v jeziku, ki ga večina spletnih razvijalcev že pozna, in sicer je to JavaScript. Do pojava Node.js platforme ste morali za celostni razvoj programske opreme dobro poznati vsaj 2 programska jezika: JavaScript na strani odjemalca in npr. PHP ali Ruby na strani strežnika. Z dostopnostjo Node.js lahko tako razvijalci porabijo vse znanje, ki ga že imajo z razvojem na strani odjemalca, še za razvoj na strani strežnika.
Zelo pomemben razlog popularnosti Node.js je tudi izjemna hitrost izvajanja kode in učinkovita raba sistemskih virov. Tako lahko Node.js aplikacije postrežejo večje število uporabnikov z manjšo porabo sistemskih virov kot večina obstoječe strežniške tehnologije. Razlog za majhno porabo sistemskih virov v Node.js je v njegovi zasnovi, ki se izvaja v 1 niti, medtem ko so tradicionalni spletni strežniki (npr. Apache in IIS) večnitni38.
Pri večnitnem delovanju spletnega strežnika je težava predvsem poraba pomnilnika, saj se vsakemu uporabniku oz. seji dodeli ločena izvajalna nit in pomnilniki (pogosto je to okrog 8 MB). Način delovanja večnitnega spletnega strežnika si lahko ogledamo na primeru bančnega poslovanja, ki je prikazan na sliki 1.12. Imamo stranki Milana in Janeza, ki povsem neodvisno uporabljata storitve banke tako, da je vsakemu dodeljen poseben bančni uslužbenec. Ta pristop deluje brez težav dokler imamo na voljo dovolj bančnih uslužbencev, ko pa število strank preseže število bančnih uslužbencev, se storitev upočasni in stranke morajo čakati. V bankah čakalne vrste niso tako problematične, medtem ko je čakanje uporabnika na daljše nalaganje spletne strani lahko večji problem, saj se lahko zgodi, da se zaradi slabe izkušnje ne bodo več vrnili na našo spletno stran. Ravno zaradi tega razloga imajo spletni strežniki po navadi veliko večjo količino pomnilnika, kot ga potrebujejo v 90% časa svojega delovanja, kar pa je finančno neučinkovito.
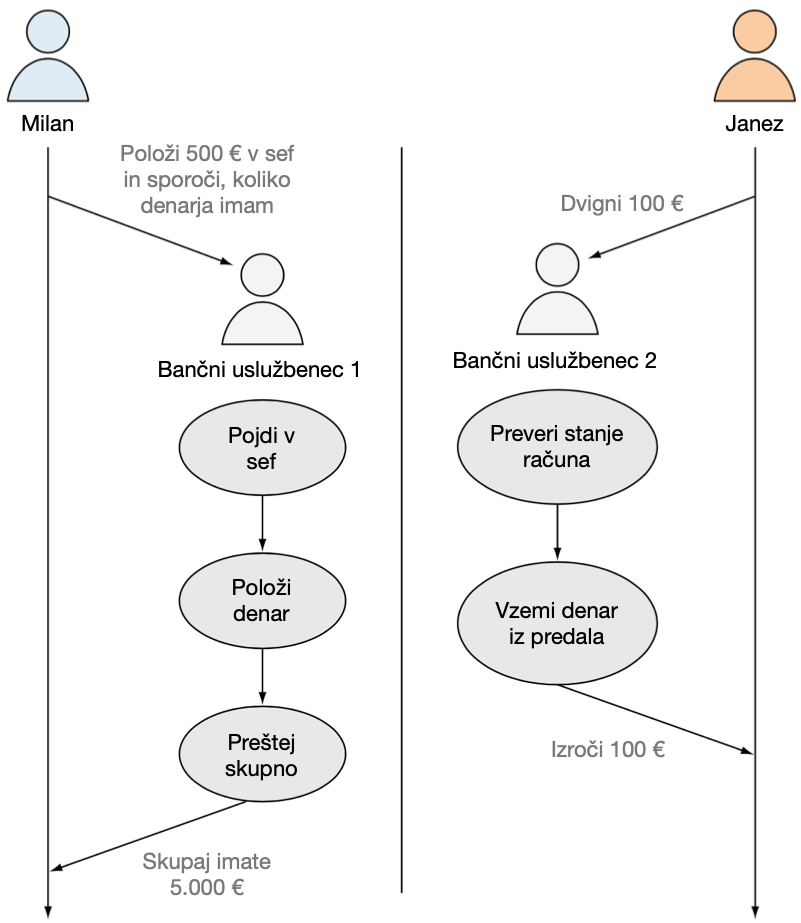
Slika 1.12: Primer večnitnega pristopa, kjer ima vsak uporabnik dodeljene ločene vire, brez medsebojnih odvisnosti.
V okolju Node.js se uporablja drugačen pristop, in sicer delovanje spletnega strežnika v eni niti. Namesto, da vsakemu uporabniku dodelimo svojo nit, vsi uporabljajo eno in tudi enotne sistemske vire. Če se vrnemo nazaj na analogijo banke, bi v primeru delovanja v eni niti imeli zgolj enega bančnega uslužbenca, ki bi sprejemal stranke. Vendar ta bančni uslužbenec ne bi opravljal funkcij zalednega sistema, le-te delegira naprej ostalim akterjem v podjetju (npr. upravljalec sefa in blagajničar), kot je prikazano na sliki 1.13. Opazimo lahko, da stranki Milan in Janez svojo zahtevo sporočita istemu bančnemu uslužbencu, v vmesnem času pa sta njuni zahtevi posredovani naprej v zaledni sistem.
Namig: Pri enonitnem delovanju se je potrebno zavedati, da si vsi uporabniki delijo osrednje sistemske vire. Pri delovanju aplikacije moramo poskrbeti, da nimamo delov kode, ki bi povzročale zakasnitve oz. blokirale ostale dele kode. Primer takšne operacije je dostop do podatkovne baze. Če bi to operacijo izvajali neposredno v čelnem delu sistema ob vsaki zahtevi, potem aplikacija ne bi zmogla izvajati nobene druge operacije.
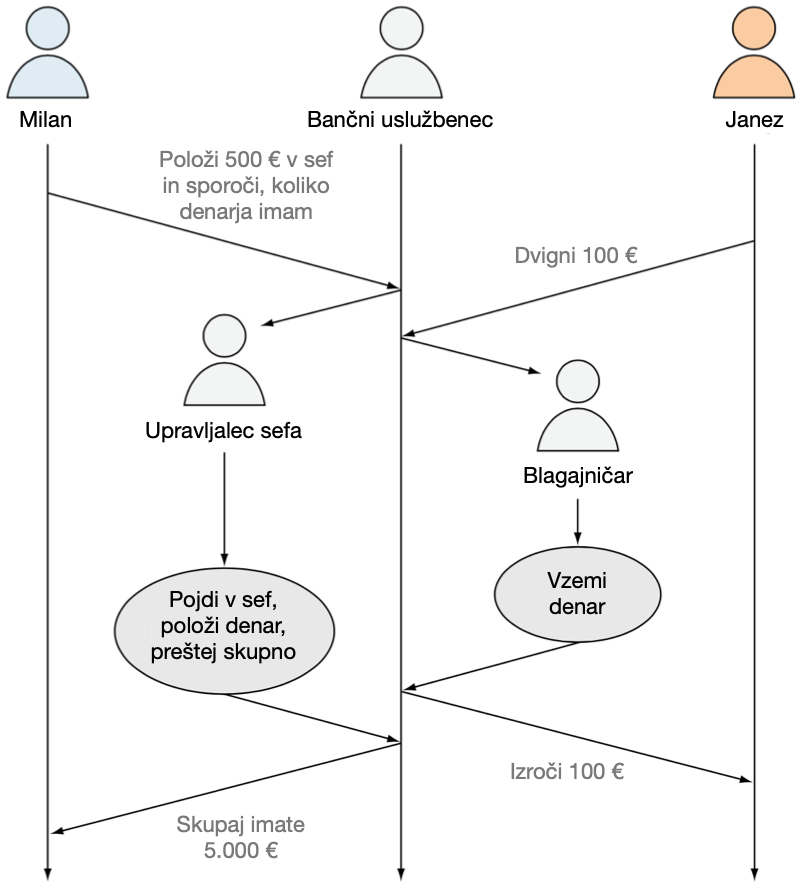
Slika 1.13: Primer enonitnega pristopa, kjer si uporabniki delijo osrednji vir in mora biti prisotna dovolj visoka stopnja discipline, da ne pride do medsebojnih odvisnosti.
Enonitni pristop ni razširljiv čez vse meje, vendar se v praksi izkaže, da je bolj učinkovit od večnitnega, predvsem ker lahko dosežemo večjo prepustnost ob manjši porabi sistemskih virov. Takšen pristop je v Node.js mogoč zaradi asinhronega delovanja jezika JavaScript.
1.3.2 Express
Express predstavlja v MEAN arhitekturi črko E. Node.js, na kratko predstavljen v prejšnjem poglavju, je platforma, ki ne predpisuje načina, kako naj bodo aplikacije zgrajene in uporabljane. Express je ogrodje za razvoj spletnih aplikacij v okolju Node.js, ki opredeljuje smernice in priporočila pri razvoju takšnih aplikacij in je eden izmed bolj priljubljenih zaradi svoje enostavnosti in razširljivosti.
Osnovna sposobnost ogrodja Express je spletni strežnik, ki ga lahko enostavno postavimo in od njega zahtevamo, da posluša na določenih vratih ter odjemalcem vrača zahtevane odgovore. Prav tako opredeljuje direktorijsko strukturo, ena izmed map je npr. namenjena strežbi statičnih vsebin na način, da ne blokira ostalih zahtev.
Prav tako omogoča zelo enostaven vmesnik za usmerjanje vhodnih URL zahtev do določenega dela izvorne kode (npr. strežba statične HTML strani, branje iz podatkovne baze, vnos podatkov v podatkovno bazo ipd.). Express nam določene stvari poenostavi in zmanjša kompleksnost uporabe v primerjavi, da bi to implementirali neposredno v Node.js.
Express ima tudi podporo za številne predloge, ki jih lahko uporabimo pri generiranju HTML vsebine na bolj pameten način s ponovno uporabo določenih komponent in vključevanje podatkov iz podatkovne baze. Express poskrbi za prevajanje vseh teh delov v končno obliko HTML strani, ki jo prikaže spletnemu brskalniku.
Ker je protokol HTTP brez stanja, je potrebno specifične lastnosti povezane s posameznim uporabnikom urejati na strani strežnika. Express nam omogoča tudi to s pomočjo obvladovanja uporabnikovih sej, kar nam olajša implementacijo na strani strežnika.
1.3.3 MongoDB
Shranjevanje in uporaba podatkov je ključna zahteva večine spletnih aplikacij in MongoDB predstavlja v MEAN arhitekturi črko M. MongoDB ni relacijska podatkovna baza, ampak jo uvrščamo med dokumentno usmerjene NoSQL39 podatkovne baze. Pri relacijski podatkovni bazi so podatki shranjeni v obliki vrstic (glej tabelo 1.2), kjer vsak stolpec opredeljuje ime in podatkovni tip atributa.
| predpona | ime | priimek | dekliskiPriimek | vzdevek |
|---|---|---|---|---|
gospod
|
Janez
|
Kranjski
|
stari
|
|
Jožica
|
Sosedova
|
|||
Marjanca
|
Tankopiska
|
Zvitolovka
|
MongoDB še vedno ohranja vrstice, vendar stolpci nimajo več takšne vloge kot v relacijskem svetu (glej tabelo 1.3). Vsaka vrstica v MongoDB predstavlja dokument, ki opredeljuje podatke (ime atributa) in vrednosti.
ime: "Janez"
|
predpona: "gospod"
|
priimek: "Kranjski"
|
vzdevek: "stari"
|
priimek: "Sosedova"
|
ime: "Jožica"
|
||
dekliskiPriimek: "Zvitolovka"
|
ime: "Marjanca"
|
priimek: "Tankopiska"
|
Kot že omenjeno, so podatki v MongoDB shranjeni v BSON40 obliki. JSON41 format je preprosto način zapisa podatkov v jeziku JavaScript in zato je MongoDB podatkovna baza zelo primerna za vključitev v MEAN arhitekturo.
Primer enostavnega BSON zapisa podatka v MongoDB je prikazan spodaj:
{
  "predpona": "gospod",
  "ime": "Janez",
  "priimek": "Kranjski",
  "vzdevek": "stari",
  _id: ObjectId("52279effc62ca8b0c1000007")
}
Iz tega primera je razvidno, da so podatki v MongoDB podatkovni bazi shranjeni v obliki dokumentov, vsebina dokumentov pa je je sestavljen iz več parov ključ / vrednost. Vsak dokument ima tudi parameter s ključem _id, ki predstavlja enolični identifikator in ga MongoDB dodeli vsakemu novemu dokumentu.
MongoDB podatkovna baza ima zelo dobro podporo sekundarnim indeksom in naprednim poizvedbam (sicer ne do polne izrazne moči SQL poizvedb). Potrebno pa se je zavedati, da MongoDB ni transakcijska podatkovna baza in je za takšne namene ni priporočljivo uporabljati. Transakcijska relacijska podatkovna baza lahko prevzame v obdelavo večje število operacij in jih obravnava kot transakcijo. Če je kakšna izmed operacij neuspešna, potem je neuspešna celotna transakcija in nobena posamezna operacija se ne izvede.
Fleksibilnost MongoDB podatkovne baze, ki nam omogoča prosto shranjevanje podatkov, je zagotovo prednost, vendar v aplikaciji kljub temu potrebujemo določen red v obliki sheme podatkov zaradi lažjega vzdrževanja. Z uporabo knjižnice Mongoose (LearnBoost 2010) se lahko načrtovanja podatkovne baze lotimo kar znotraj aplikacije. Načrtovanje podatkov v kontekstu MongoDB preprosto pomeni opredelitev dokumenta in podatkov, ki jih bomo znotraj dokumenta shranjevali. Če želimo npr. shranjevati podatke o uporabniku, bi se lahko odločili za ime, priimek, elektronski naslov in telefonsko številko. Pri tem bi zahtevali obvezno prisotnost zgolj za ime in elektronski naslov, kjer bi morale biti vrednosti elektronskega naslova enolične. Ti podatki so tako zapisani v shemi, ki se uporablja kot osnova za model. Poleg podpore načrtovanju podatkov Mongoose omogoča tudi lažje obvladovanje hkratnih povezav do podatkovne baze kot tudi poenostavljeno branje in pisanje podatkov.
1.3.4 Angular
Angular predstavlja v MEAN arhitekturi črko A. Gre za JavaScript ogrodje za neposredno delo s podatki na strani odjemalca. Popolnoma delujočo spletno aplikacijo lahko zgradimo že s pomočjo Node.js, Express in MongoDB in to bomo tudi naredili v okviru tega tečaja. Z dodajanjem Angular na uporabljen sklad tehnologij pa zgolj izboljšamo celotno uporabniško izkušnjo. Pri tradicionalnem pristopu je namreč procesiranje podatkov na strežniku, ki nato odjemalcu posreduje HTML dokument, ki ga prikaže v spletnem brskalniku. Angular pa omogoča prenos dela te logike in procesiranja v spletni brskalnik pri odjemalcu, kjer pogosto strežnik zgolj posreduje podatke iz podatkovne baze.
V jeziku JavaScript obstajajo številna ogrodja in knjižnice, kjer je ena izmed najbolj priljubljenih jQuery (jQuery Foundation 2006). Angular in jQuery sta po osnovnem načinu delovanju zelo različna, saj jQuery po navadi vključimo na že obstoječo spletno stran, ki ji želimo dodati interaktivnost po tem, ko se je stran že naložila. Vloga Angular pa pride prej, saj pomaga pri generiranju spletne strani z vključevanjem dinamičnih podatkov. Ena izmed ključnih prednosti Angular je takojšnja posodobitev spletne strani, ko se spremeni podatek. To funkcionalnost poznamo pod imenom dvosmerno povezovanje podatkov.
Enosmerno povezovanje podatkov je prisotno pri npr. uporabi Node.js, Express in MongoDB, kjer Node.js pridobi podatke iz MongoDB podatkovne baze, nato Express s pomočjo prevajanja predlog in podatkov generira HTML dokument, ki ga posreduje odjemalcu, kot to prikazuje slika 1.14. Takšen način razvoja spletnih aplikacij je zelo pogost in večina dela se izvede na strani strežnika, medtem ko mora odjemalec zgolj prikazati HTML dokument in izvesti potencialne interaktivne elemente v jeziku JavaScript.
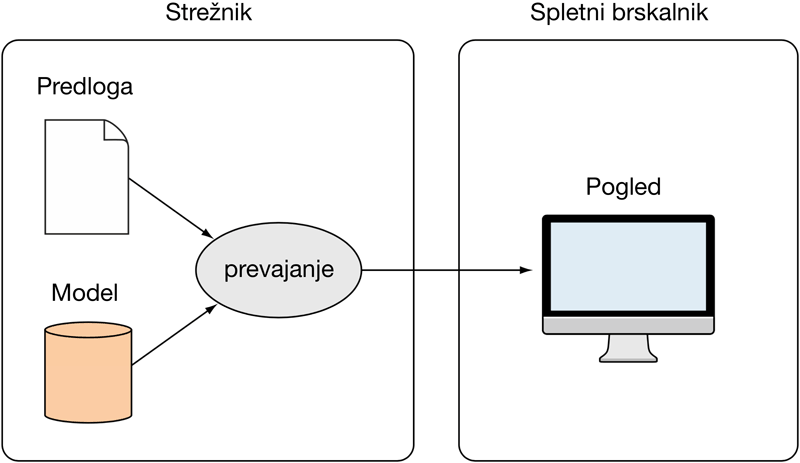
Slika 1.14: Enosmerno povezovanje podatkov, kjer se predloga in model prevedeta na strežniku, preden je odgovor posredovan odjemalcu.
Pri dvosmernem povezovanju podatkov, kot to prikazuje slika 1.15, se odjemalcu predloga in podatki ločeno posredujeta v pogled in model. Ključna razlika je v tem, da je pogled v realnem času, tj. povezan je z modelom in odraža vsako spremembo, kar velja tudi v drugi smeri. Podatki so s strani strežnika po navadi na voljo preko API42-ja in niso tesno povezani z aplikacijo, vendar je na strani odjemalca še vedno potrebno manjše procesiranje za preslikavo v model.
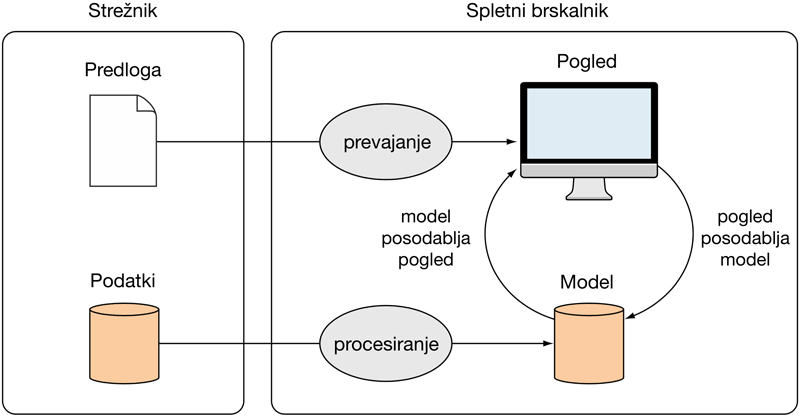
Slika 1.15: Dvosmerno povezovanje podatkov, kjer sta model in pogled v brskalniku medsebojno povezana in odvisna.
Angular je še posebej primeren za razvoj spletnih aplikacij na eni strani43, kjer se večji del aplikacije izvaja znotraj brskalnika in stran se nikoli v celoti ne naloži znova. To pomeni, da lahko vso aplikacijsko logiko, procesiranje podatkov, premikanje uporabnikov po strani in prevajanje predlog izvajamo neposredno v brskalniku. Primer takšne SPA aplikacije je Gmail. Na strani se prikazujejo različni pogledi, vključno z različnimi skupinami podatkov, ampak stran se nikoli v celoti ponovno ne naloži. S takšnim pristopom lahko dejansko zmanjšamo potrebne sistemske vire na strani strežnika in dejansko izvajamo množičenje računske moči, saj vsak odjemalec izvaja procesiranje s svojim brskalnikom, strežnik pa zgolj posreduje statične datoteke in podatke na zahtevo. Izboljša se tudi uporabniška izkušnja, saj je enkrat, ko je aplikacija naložena, potrebnih manj klicev na strežnik.
Kljub vsem prednostim pa Angular ni primeren za vsako spletno stran. Za izvedbo postopnih izboljšav je zagotovo bolj primeren jQuery. Če določena stran deluje brez podpore JavaScript, ji z vpeljavo jQuery dodamo določeno interaktivnost. Pri Angular je podpora JavaScript nujno potrebna, saj je celotno procesiranje na strani odjemalca. Če je na Angular SPA kakšna napaka, potem aplikacija ne bo delovala. Prav tako so lahko težave z indeksiranjem vsebine spletne aplikacije s strani spletnih iskalnikov.
Pogosto pa se v praksi pri razvoju naprednih spletnih aplikacij odločamo za selektivno vključitev SPA pristopa, medtem ko na preostanku funkcionalnosti uporabimo standardni pristop. Kjer imamo zelo frekventno izmenjavo podatkov ali sekcij aplikacije, je uporaba Angular SPA zelo priporočljiva. Če pa je del aplikacije npr. kakšen blog, potem v tem primeru ni potrebno uporabiti SPA pristopa.
Ta prilagodljivost (del aplikacije je podprt z Node.js, Express in MongoDB, medtem ko je drug del implementiran z Angular SPA), ki jo omogoča uporaba MEAN arhitekture, je tudi ena izmed večjih prednosti uporabi na praktičnih projektih.
1.3.5 Podporna orodja, ogrodja in knjižnice
1.3.5.1 Bootstrap
V okviru tega tečaja bomo uporabljali tudi Bootstrap (Twitter 2011) za izdelavo odzivnega uporabniškega vmesnika, ki bo deloval tudi na mobilnih napravah. Za MEAN arhitekturo uporaba omenjenega ogrodja ni obvezna, nam pa zelo olajša razvoj pri našem pristopu hitrega prototipiranja. Bootstrap opredeljuje odzivno razporeditev v obliki mreže. S takšnim pristopom lahko prilagodimo vsebino različnim napravam (npr. namizni računalniki, prenosniki, tablice in telefoni), ki se razlikujejo predvsem v ločljivosti zaslona. S pomočjo uporabe jezikov HTML in CSS lahko zgolj v eni HTML datoteki pripravimo uporabniški vmesnik, ki se ustrezno prikaže na vseh teh različnih napravah. To dosežemo s pomočjo uporabe vnaprej opredeljenih CSS razredov, ki so na voljo za večino HTML gradnikov spletne strani. Ogrodje Bootstrap podpira tudi teme, tako da si lahko v celoti zamenjamo izgled končne aplikacije brez dodatnih sprememb aplikacije.
1.3.6 Git
Pri razvoju kompleksne programske opreme je zelo pomembno obvladovanje verzij, za kar bomo v našem primeru uporabljali sistem Git. V najbolj enostavni postavitvi imamo lokalni repozitorij na svojem razvojnem računalniku in oddaljen centraliziran repozitorij na GitHub. Pri razvoju bomo stalno posodabljali lokalni repozitorij in posredovali spremembe v oddaljen repozitorij.
Git bomo, poleg očitnega razloga, za verzioniranje, uporabljali tudi za prenos izvorne kode naše aplikacije v produkcijsko okolje Heroku, ki bo predstavljeno v nadaljevanju.
1.4 Razvoj dejanske aplikacije
Pri tečaju bomo s pomočjo MEAN arhitekture od začetka do konca izpeljali celostni razvoj aplikacije, ki bo podatke pridobivala in zapisovala v podatkovno bazo, uporabljala zunanje storitve in del funkcionalnosti ponujala v obliki spletne aplikacije na eni strani.
Pri razvoju bomo uporabljali MEAN arhitekturo, kjer je enotni programski jezik JavaScript in enoten format podatkov JSON, kot je prikazano na sliki 1.16.
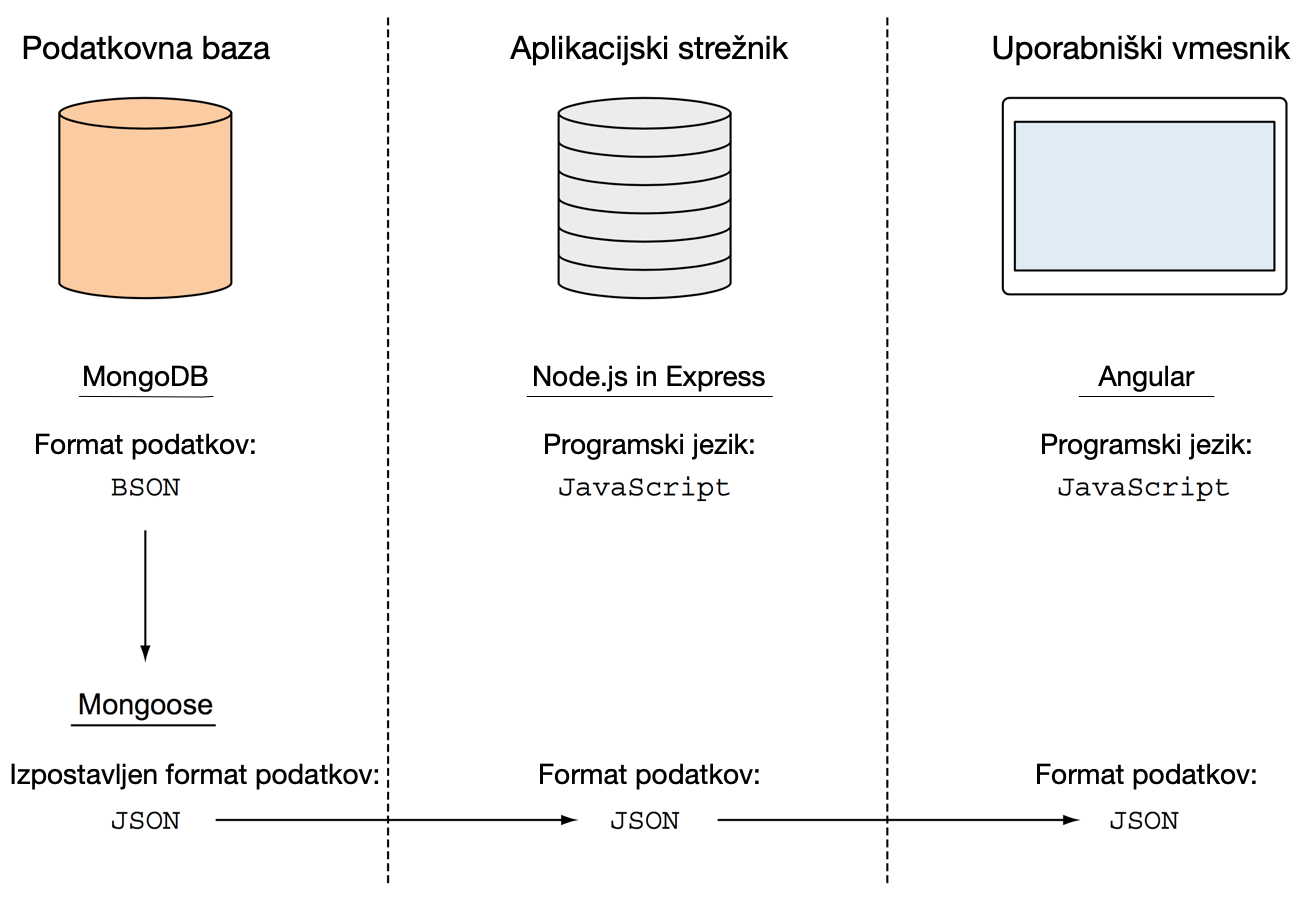
Slika 1.16: Enoten programski jezik JavaScript in JSON enoten format podatkov v MEAN arhitekturi.
Podatki bodo v MongoDB podatkovni bazi shranjeni v BSON formatu, medtem ko bodo preko Mongoose izpostavljeni v JSON obliki. Express ogrodje nadgrajuje platformo Node.js, kjer bo vsa izvorna koda napisana v programskem jeziku JavaScript. Na uporabniškem vmesniku bomo uporabljali Angular, kjer bo zopet v uporabi programski jezik JavaScript oz. TypeScript.
1.5 Načrtovanje aplikacije po MEAN arhitekturi
Pogost pristop k načrtovanju aplikacije po MEAN arhitekturi je z uporabo REST44 API-jev, ki posredujejo podatke na SPA spletno aplikacijo na eni strani. API po navadi implementiramo s pomočjo MongoDB, Express in Node.js, medtem ko je uporabniški vmesnik SPA aplikacije podprt z Angular, kar je prikazano na sliki 1.17.
REST je arhitekturni stil, ki je brez stanja, tj. ne zaveda se trenutnega stanja uporabnika oz. nima zgodovine. API omogoča aplikacijam medsebojno komuniciranje. REST API tako predstavlja programski vmesnik brez stanja. V primeru MEAN arhitekture se REST API uporablja za vmesnik do podatkovne baze, kar omogoča ostalim aplikacijam delo s podatkovno bazo.
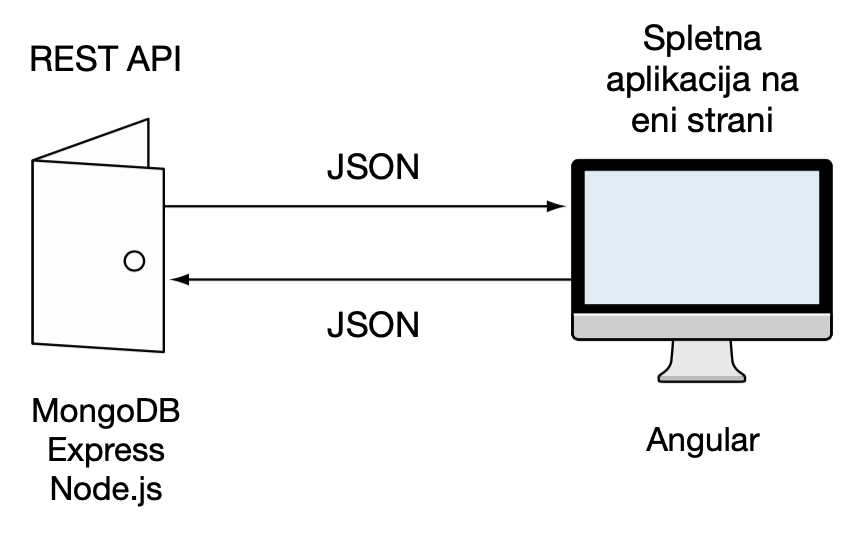
Slika 1.17: Klasičen pristop k razvoju aplikacij z MEAN arhitekturo, kjer uporabljamo MongoDB, Express in Node.js, da zgradimo REST API-je, ki posredujejo JSON podatke na Angular SPA spletno aplikacijo na eni strani z izvajanjem v uporabnikovem brskalniku.
Vedno pa SPA pristop pri razvoju spletnih aplikacij ni priporočljiv. Ena izmed težav je indeksiranje s strani spletnih iskalnikov. JavaScript na strani odjemalca je namreč zelo težko indeksirati, saj iskalniki praviloma JavaScript na strani odjemalca ne izvajajo. Kljub temu imamo pri razvoju SPA aplikacije možnost uporabiti določene pristope, ki nam to vsaj delno omogočijo. V vsakem primeru moramo pripraviti ločene HTML strani, ki so enake dinamično generiranim v SPA. Vsi takšni pristopi so kar zahtevni in na koncu moramo vzdrževati še bolj kompleksno spletno mesto. Ena izmed težav pri uporabi SPA aplikacij je tudi analitika uporabe spletnega mesta in zgodovina brskanja, kar je pri SPA zelo omejeno. S pomočjo HTML5 history API sicer lahko poskrbimo za izboljšano podporo temu vidiku, vendar obvladovanje te kompleksnosti lahko kmalu postane težavno. Hitrost nalaganja začetne strani je lahko tudi težava pri uporabi SPA, saj je potrebno ob prihodu na stran naložiti vsa ogrodja in programsko logiko, da začnemo izvajati aplikacijo v spletnem brskalniku. To pomanjkljivost lahko delno odpravimo s predpomnjenjem in nalaganjem virov po potrebi oz. ob zahtevi za uporabo.
Poglejmo si problemsko domeno obvladovanja spletnega mesta, kjer so na voljo blog zapisi, poleg tega pa imamo tudi upravljalski vmesnik za obvladovanje in kako lahko to problemsko domeno implementiramo z uporabo MEAN arhitekture. Kot že omenjeno, imamo najprej javno stran, ki prikazuje različne blog zapise ter upravljalski vmesnik, preko katerega lahko avtor bloga dodaja nove zapise in obvladuje obstoječe. Slika 1.18 prikazuje nekaj ključnih lastnosti posameznega dela sistema.
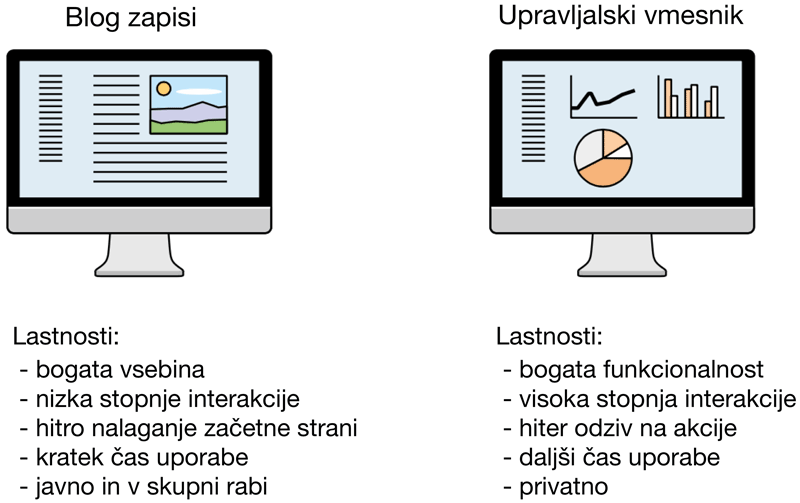
Slika 1.18: Nasprotujoče lastnosti različnih spletnih strani.
Če preverimo lastnosti ene in druge strani, lahko opazimo nekaj konfliktov, kot je npr. stopnja interakcije, bogata vsebina v nasprotju z bogato funkcionalnostjo, interaktivnost upravljalskega vmesnika itd. Na drugi strani zahtevamo hitro nalaganje strani z blog zapisi. Če upoštevamo vse te omejitve, se verjetno ne bi odločili za uporabo SPA na strani prikazovanja blog zapisov, medtem ko bi bil upravljalski vmesnik veliko bolj primeren za spletno aplikacijo na eni strani.
V tem primeru lahko ločeno podpremo posamezne funkcionalnosti tako, da imamo dve posamezni aplikaciji - javno vsebino, ki jo strežnik neposredno prikaže v obliki HTML dokumentov, in upravljalski vmesnik, ki bo implementiran kot SPA. Slika 1.19 prikazuje primer implementacije upravljalskega vmesnika, kjer uporabimo Angular za SPA, kjer se med REST API-jem na zalednem delu prenašajo JSON podatki.
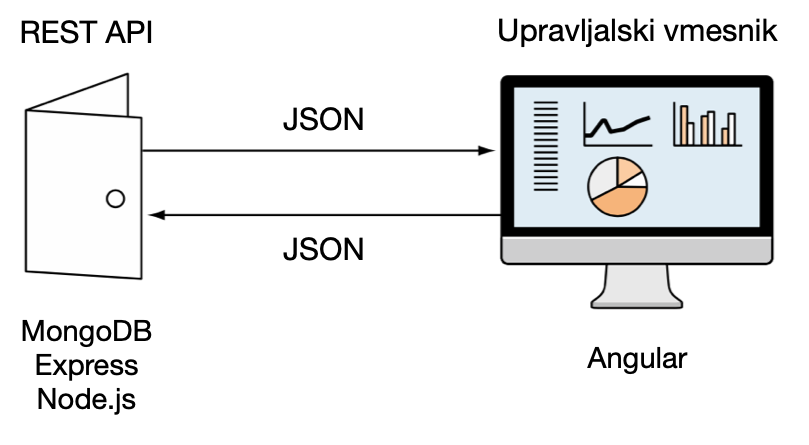
Slika 1.19: Upravljalski vmesnik je primeren za implementacijo v obliki Angular SPA spletne aplikacije na eni strani, kjer je REST API implementiran z MongoDB, Express in Node.js.
Ko razmišljamo o prikazu javnih blogov pa uporaba Angular ni ravno najboljša rešitev. Ugotovimo lahko, da je v MEAN arhitekturi na voljo tudi Express, ki nam omogoča generiranje HTML vsebine s pomočjo prevajanja predlog in podatkov iz podatkovne baze. Za dostop do podatkovne baze lahko uporabimo kar REST API, medtem ko strežnik in Express HTML vsebino odjemalcu neposredno posredujeta, kot to prikazuje slika 1.20.
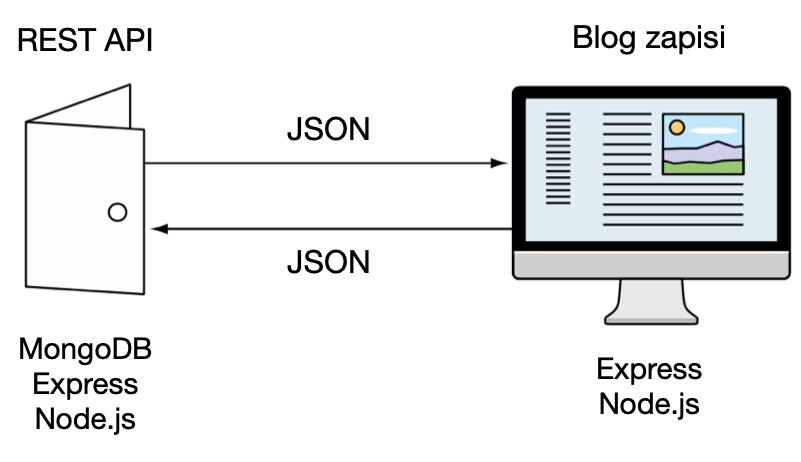
Slika 1.20: Neposredno pošiljanje HTML dokumenta z Express in Node.js na čelni strani sistema in REST API na zaledni strani z MongoDB, Express in Node.js.
Obstoječi rešitvi prikaza blog zapisov lahko dodamo še ostale tehnologije MEAN arhitekture, kot je prikazano na sliki 1.21. Če bi npr. želeli, da se uporabniki prijavijo na stran, kjer lahko nato komentirajo članke, je potrebno dodati obvladovanje sej. To lahko dosežemo z uporabo podatkovne baze MongoDB in Express ogrodja. Mogoče bi želeli dodati tudi nekaj dinamične vsebine v obliki stranske vrstice, kjer bi se prikazovali sorodni članki ali iskalno polje s samodejnim izpolnjevanjem delno vpisanih iskalnih nizov. Slednje funkcionalnosti bi lahko implementirali z uporabo Angular (ni nujno, da ga uporabljamo zgolj za SPA, ampak tudi za dodajanje dinamičnih elementov na stran).
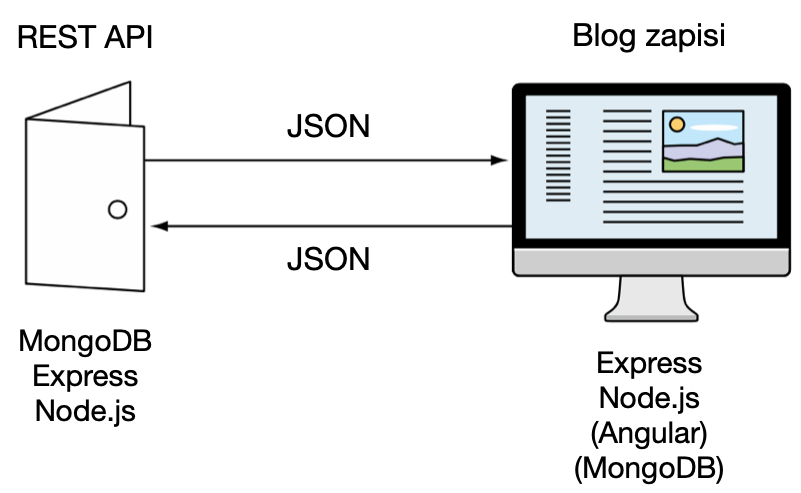
Slika 1.21: Dodana Angular in MongoDB na čelnem delu za dinamične elemente na strani odjemalca.
Tako smo prišli do dveh ločenih aplikacij, kjer vsaka uporablja REST API. Z dobrim pristopom k načrtovanju je to lahko skupen REST API, ki ga uporabljata obe aplikaciji. Slika 1.22 tako prikazuje enotno arhitekturo z enim REST API dostopom do podatkovne baze, ki komunicira z dvema čelnima aplikacijama.
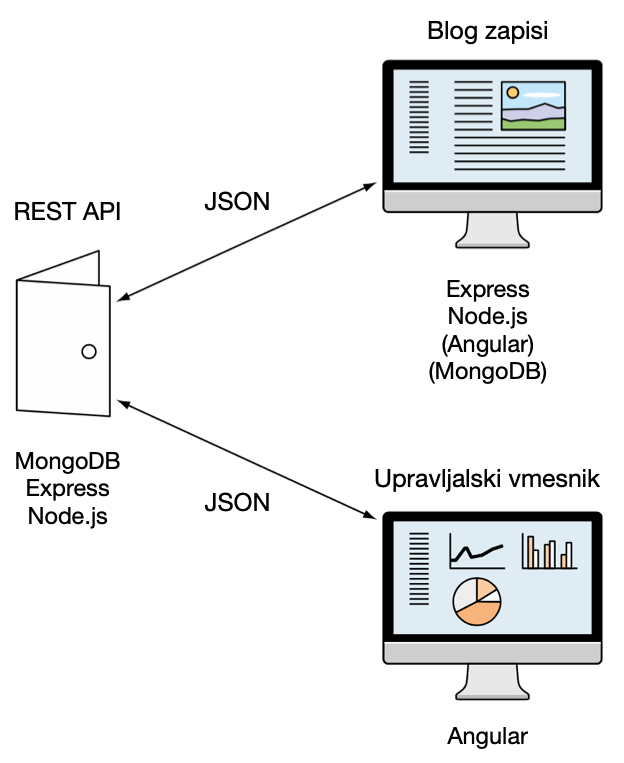
Slika 1.22: Hibridna MEAN arhitektura z REST API dostopom do podatkovne baze, ki ga uporabljata 2 aplikaciji, zgrajeni z različnimi tehnologijami MEAN arhitekture.
1.6 Dobre prakse pri načrtovanju in implementaciji aplikacije
1.6.1 Uporaba API-ja za dostop do podatkovne ravni
Ko začnemo z implementacijo spletne aplikacije v okolju Node.js in Express, kjer posredujemo HTML vsebino neposredno iz strežnika, bi bilo dostop do podatkovne baze zelo enostavno vključiti kar neposredno v Node.js aplikaciji. Bolj generičen in priporočljiv dostop pa je z uporabo API vmesnika, kot je prikazano na sliki 1.23.
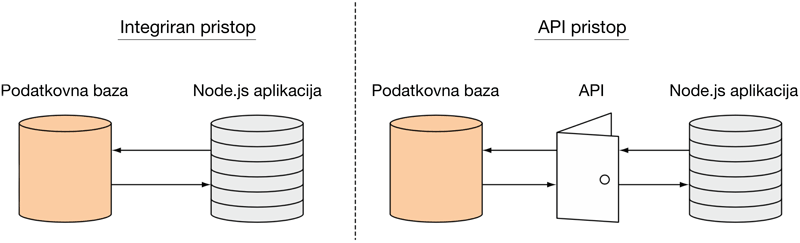
Slika 1.23: Različen način dostopa do podatkov, bodisi neposreden dostop, bodisi preko API vmesnika.
Zagotovo je na tem mestu vprašanje, zakaj vpeljati vmesno raven, v obliki API-ja za dostop do podatkovne baze. Ko gledamo zgolj dostop do podatkovne baze, ta vmesni sloj res izgleda odvečen, vendar se izkaže, da postane koristen kasneje, pri nadaljnjem razvoju spletne aplikacije. Če bi npr. želeli razviti še mobilno aplikacijo ali Angular aplikacijo, bi lahko neposredno kar uporabili API dostop do podatkov. Zelo pozitiven vidik uporabe API-ja je tudi neodvisnost od izbrane tehnologije implementacije, saj je to lahko Node.js, Angular, iOS, kot je prikazano na sliki 1.24. Če bi v predstavljenem primeru uporabili integriran pristop, potem takšna rešitev postane zelo razdrobljena in kompleksna, saj bi bilo potrebno vzdrževati 3 različne integracije, kar bi zagotovo povzročilo težave pri vzdrževanju konsistence ob dodajanju novih funkcionalnosti.
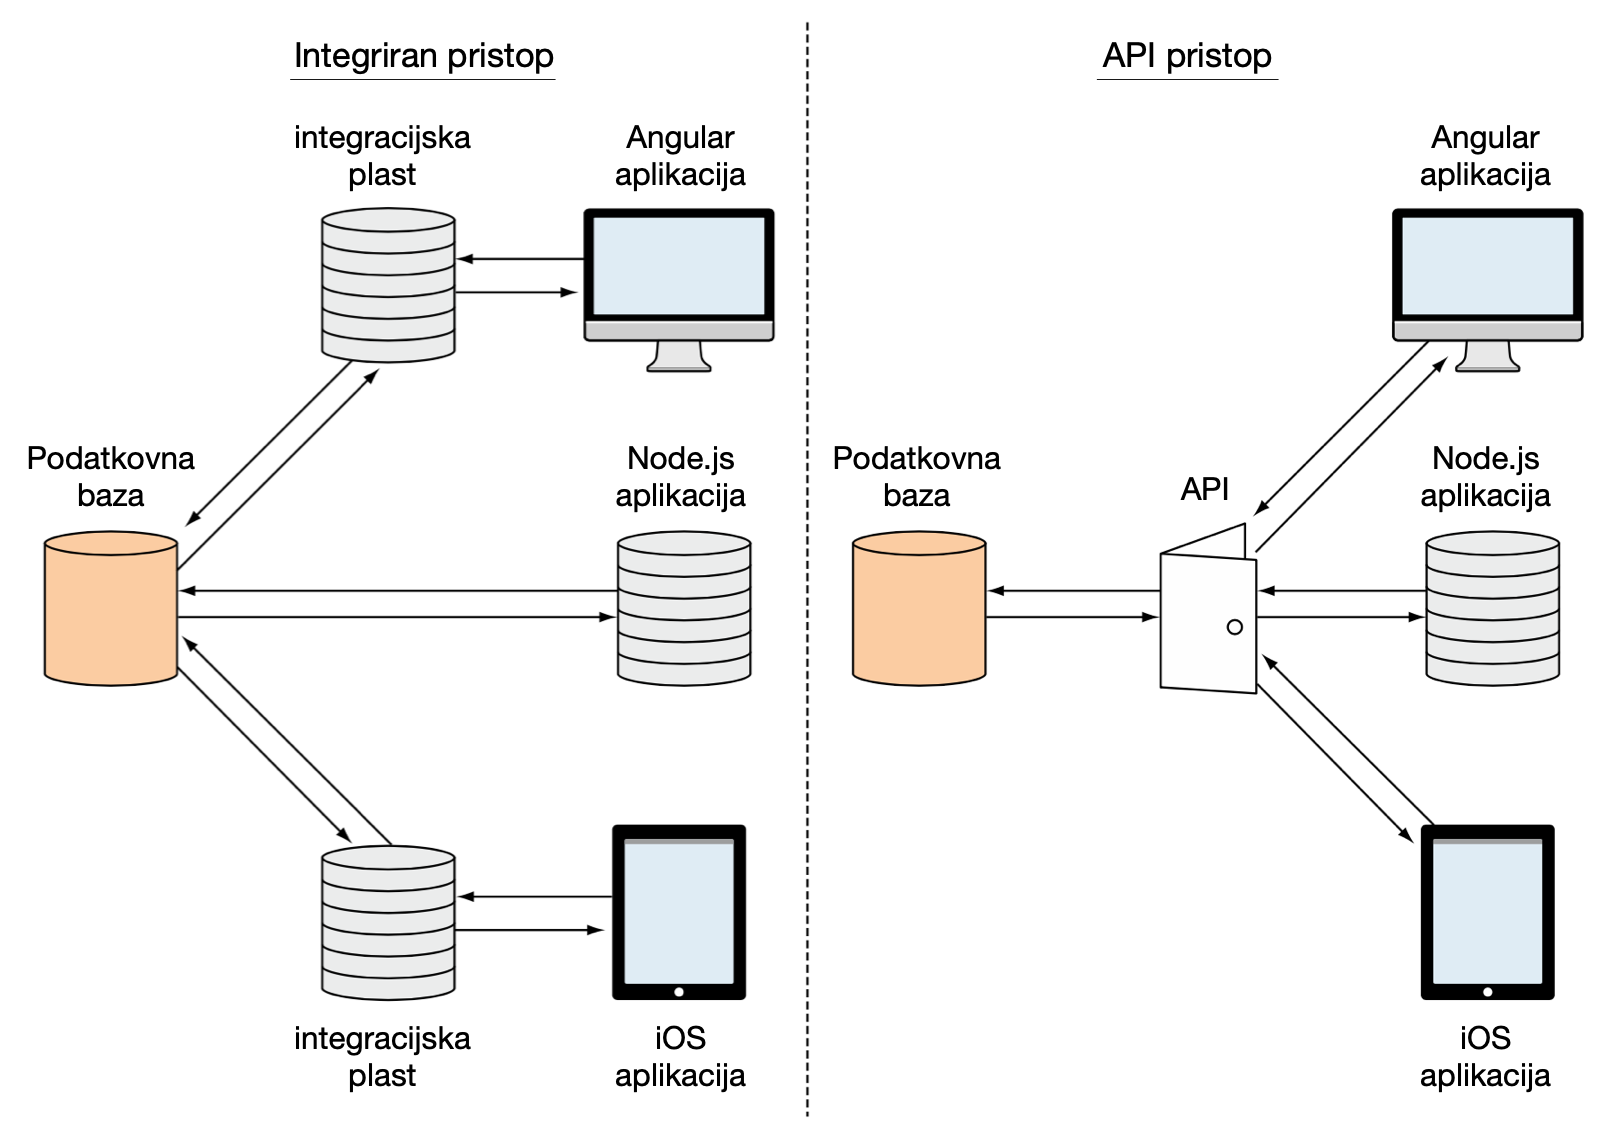
Slika 1.24: Prednosti API pristopa z naraščanjem števila različnih odjemalskih aplikacij.
1.6.2 Koraki pri načrtovanju nove spletne aplikacije
1.6.2.1 Osnovni namen aplikacije, brez tehničnih podrobnosti
Pri načrtovanju nove spletne aplikacije je smiselno začeti razmišljati o različnih zaslonih, ki bodo sestavljali uporabniški vmesnik. Tu naj bo poudarek predvsem na posameznih straneh in načinih prehoda med temi stranmi. Na začetku lahko načrt pripravimo brez tehničnih podrobnosti in ga tudi skiciramo na papir ali uporabimo kakšno orodje za hitro načrtovanje uporabniškega vmesnika (npr. Balsamiq Mockups, OmniGraffle, proto.io idr.). Ker v začetni fazi še nimamo nobenih podatkov iz podatkovne baze, ampak vnaprej opredeljene testne podatke, je tudi enostavno spreminjanje osnovnih konceptov aplikacije.
Pri tečaju bomo iterativno razvijali spletno aplikacijo s prikazom zanimivih lokacij, ki je idejno podobna igri Geocaching. Geocaching je moderna oblika iskanja skritih zakladov z uporabo GPS sprejemnikov. Razširjeno po celem svetu jo lahko razumemo kot pustolovsko igro, zabavo ali šport. Nekdo skrije “zaklad”, škatlo z določeno vsebino, na svetovnem spletu objavi njeno lokacijo (zemljepisno širino in dolžino zaklada), drugi pa gredo na lov. Ko je zaklad najden, se je potrebno vpisati v njegov dnevnik. Najditelj svojo najdbo vpiše na spletno stran, kjer je sprva dobil informacije in koordinate o zakladu.
Namen naše aplikacije bo:
Spletna aplikacija prikazuje bližnje zanimive lokacije, ki so za potencialnega turista zanimive za ogled. Poleg same lokacije so na voljo tudi dodatne informacije, katere aktivnosti so na voljo na lokaciji, odpiralni čas, ocena in podrobna lokacija na zemljevidu. Uporabniki aplikacije bodo lahko posamezno lokacijo ocenili in podali komentar.
Iz omenjenega opisa lahko nadaljujemo načrtovanje v smeri zaslonov, ki jih bo naša aplikacija potrebovala v okviru uporabniškega vmesnika:
- zaslon, ki prikazuje bližnje zanimive lokacije,
- zaslon, ki prikazuje podrobnosti izbrane zanimive lokacije,
- zaslon za dodajanje komentarja in ocene zanimive lokacije,
- zaslon z osnovnimi informacijami o aplikaciji in avtorju.
Ko identificiramo potrebne zaslone uporabniškega vmesnika, jih je smiselno logično združiti skupaj, kot to prikazuje slika 1.25. Iz zgornjega seznama lahko prve tri zaslone vsebinsko združimo v skupino, ki se ukvarja z lokacijami. Stran z osnovnimi informacijami pa lahko spada v kategorijo “ostalo”.
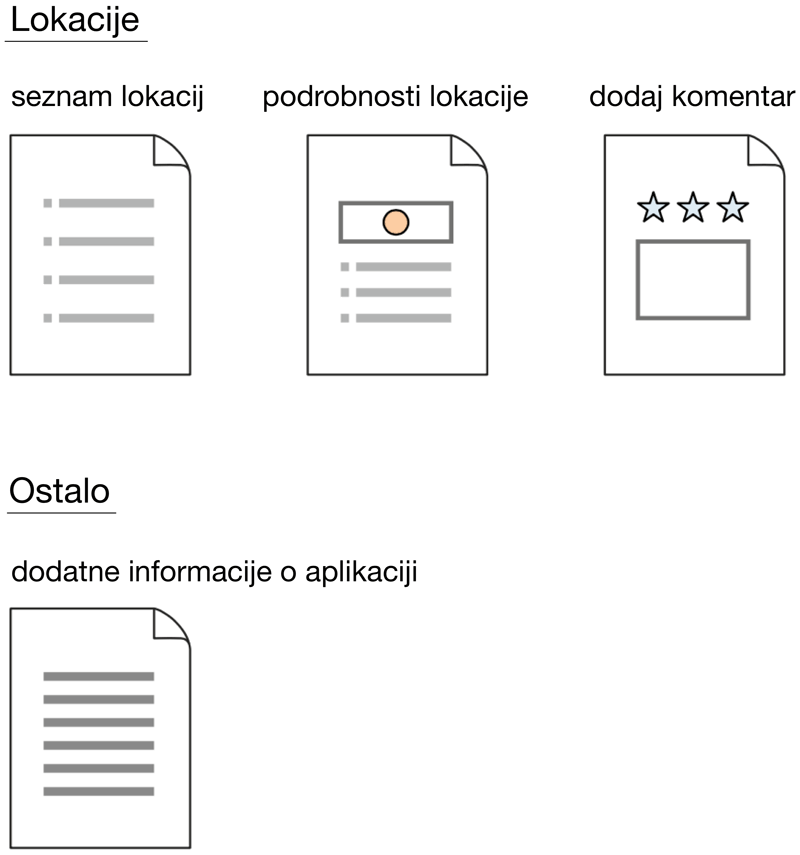
Slika 1.25: Vsebinsko združevanje načrtovanih zaslonov uporabniškega vmesnika.
1.6.2.2 Arhitekturna zasnova aplikacije
Naša aplikacija je zelo enostavna, ki jo sestavlja majhno število zaslonov, vendar moramo vseeno razmisliti o njeni arhitekturi, tj. na kakšen način se bodo podatki prenašali iz podatkovne baze do spletnega brskalnika, na kakšen način bodo uporabniki manipulirali s podatki in kako se bodo spremembe posredovale nazaj v podatkovno bazo.
Ker naša aplikacija potrebuje dostop do podatkovne baze, bomo začeli z arhitekturo aplikacije, ki je prikazana na sliki 1.26, kjer bomo implementirali REST API s pomočjo Express in Node.js ter na takšen način komunicirali s podatkovno bazo MongoDB.
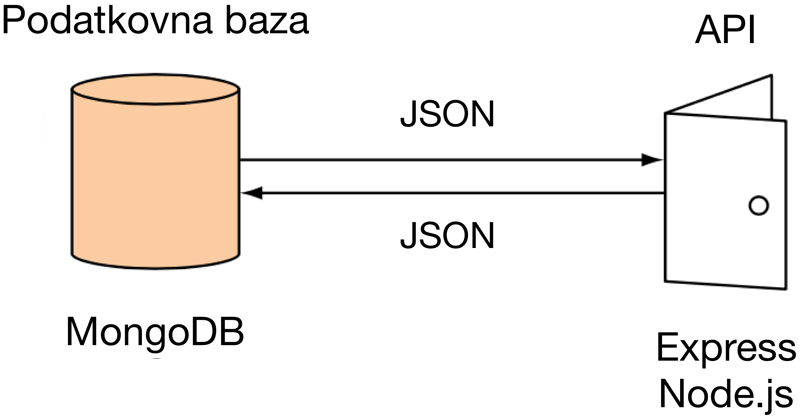
Slika 1.26: Začnemo s standardnimi tehnologijami MEAN arhitekture, tj. REST API z uporabo MongoDB, Express in Node.js.
Ko imamo rešitev glede dostopa do podatkovne baze implementirane v obliki REST API-ja, se je potrebno vprašati, na kakšen način bo implementiran preostanek aplikacije. Zagotovo bomo uporabili tehnologije MEAN arhitekture, vendar imamo številne možnosti glede kombinacij izbranih tehnologij in načinov uporabe.
Pri aplikaciji nimamo posebnih zahtev glede indeksiranja vsebine aplikacije s strani spletnih iskalnikov. Če bi želeli pripeljati čim več uporabnikov preko spletnih iskalnikov do posameznih delov aplikacije, potem bi bilo o tem smiselno razmisliti. V nasprotnem primeru pa bi zgolj delali na promociji aplikacije same po sebi in potem ni tako pomembno, da je celotna vsebina aplikacije indeksirana s strani spletnih iskalnikov. Če se vrnemo nazaj na naš primer z blog zapisi in upravljalskim vmesnikom, predstavljenem v poglavju 1.5, potem lahko identificiramo naslednje arhitekturne zasnove, ki so tudi prikazane na sliki 1.27:
1 Node.js in Express aplikacija,
2 Node.js in Express aplikacija z dodanim Angular za interaktivnost,
3 Angular za SPA aplikacijo na eni strani.
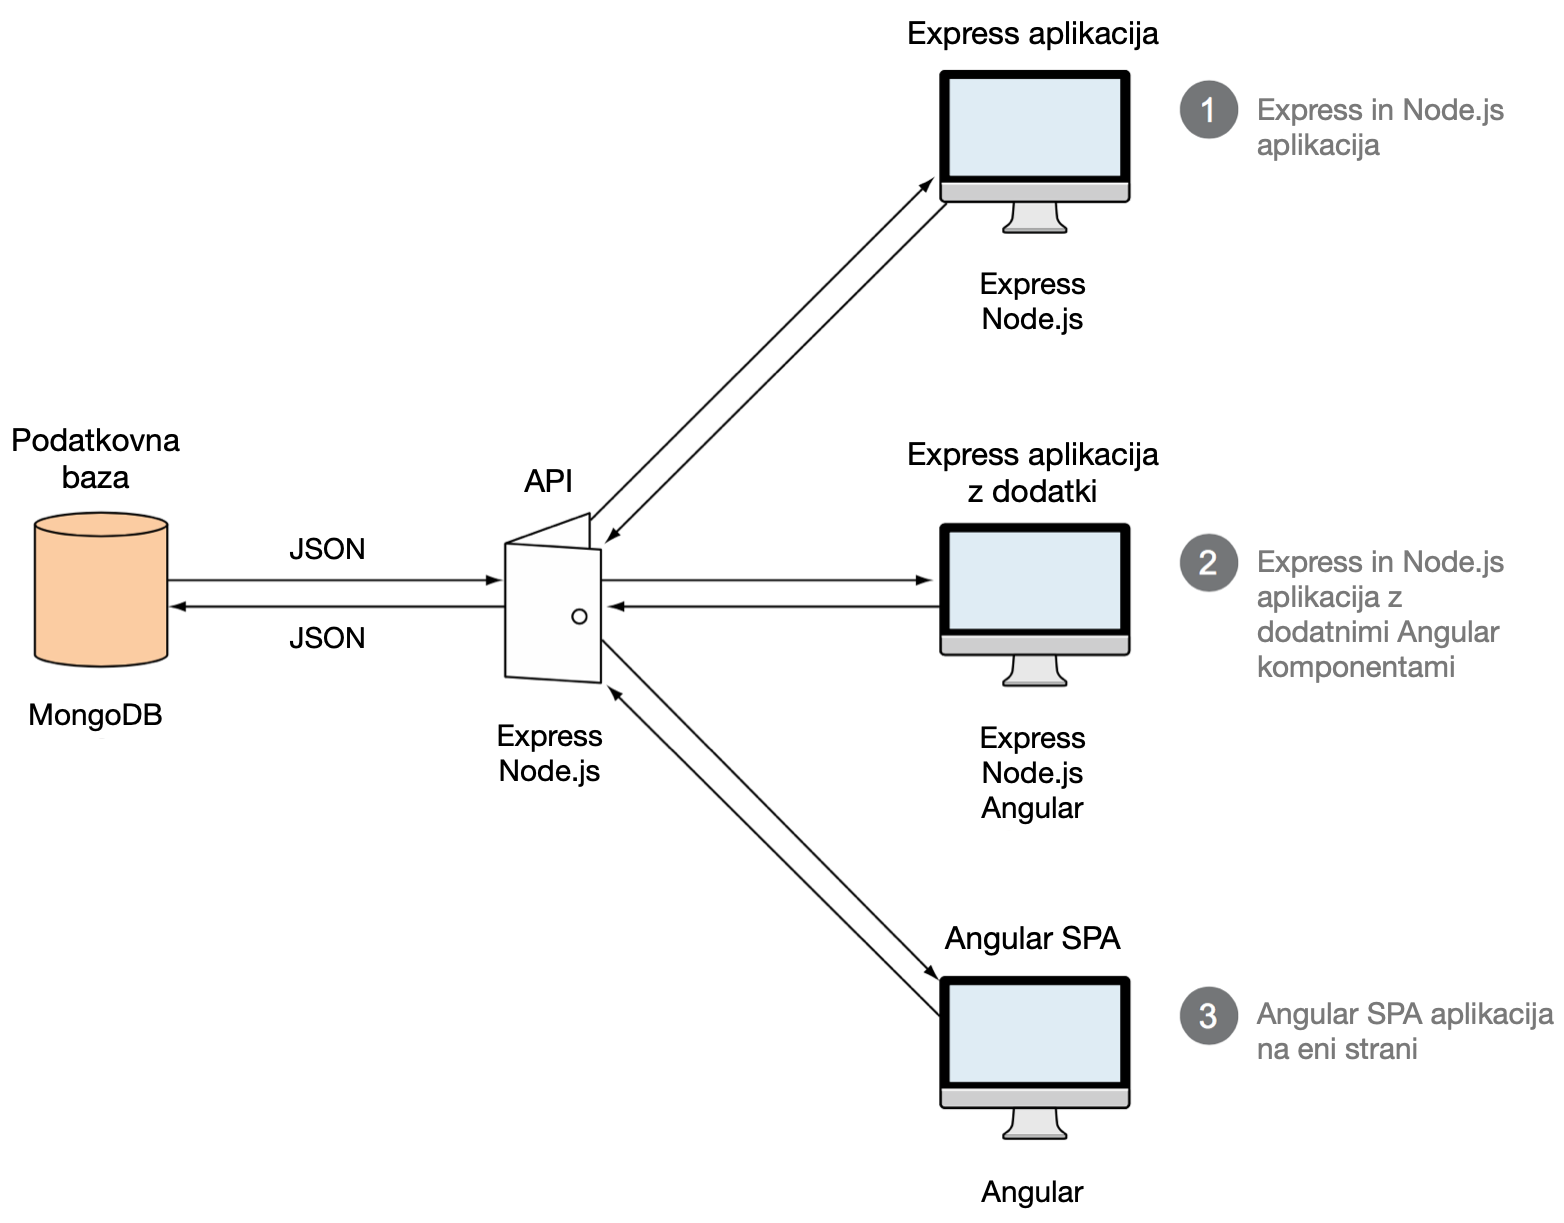
Slika 1.27: Različne arhitekturne možnosti pri razvoju spletne aplikacije.
Ker nimamo točno določenih zahtev tudi pri izbiri arhitekturne možnosti nimamo težav in bomo v okviru tečaja dejansko implementirali vse tri arhitekturne pristope. Najprej bomo implementirali 1Express aplikacijo, nato bomo 2dodali interaktivnost z izbranimi Angular komponentami in na koncu bomo aplikacijo pretvorili v 3Angular SPA aplikacijo na eni strani.
Arhitekturni diagrami, ki smo jih pripravili do tega trenutka, predvidevajo, da imamo ločeno aplikacijo za API in ločeno aplikacijo za poslovno logiko. To je povsem izvedljivo in tudi priporočljivo za večje projekte, kjer pričakujemo večjo količino prometa in lahko posamezne komponente tudi namestimo na različne računalnike za doseganje večje prepustnosti.
V našem primeru bomo postavitev nekoliko poenostavili in bomo obe funkcionalnosti združili v skupen Express projekt, kar pomeni, da bomo imeli eno aplikacijo (glej sliko 1.28) in s tem tudi manj težav pri gostovanju aplikacije v produkcijskem okolju in vzdrževanju izvorne kode.
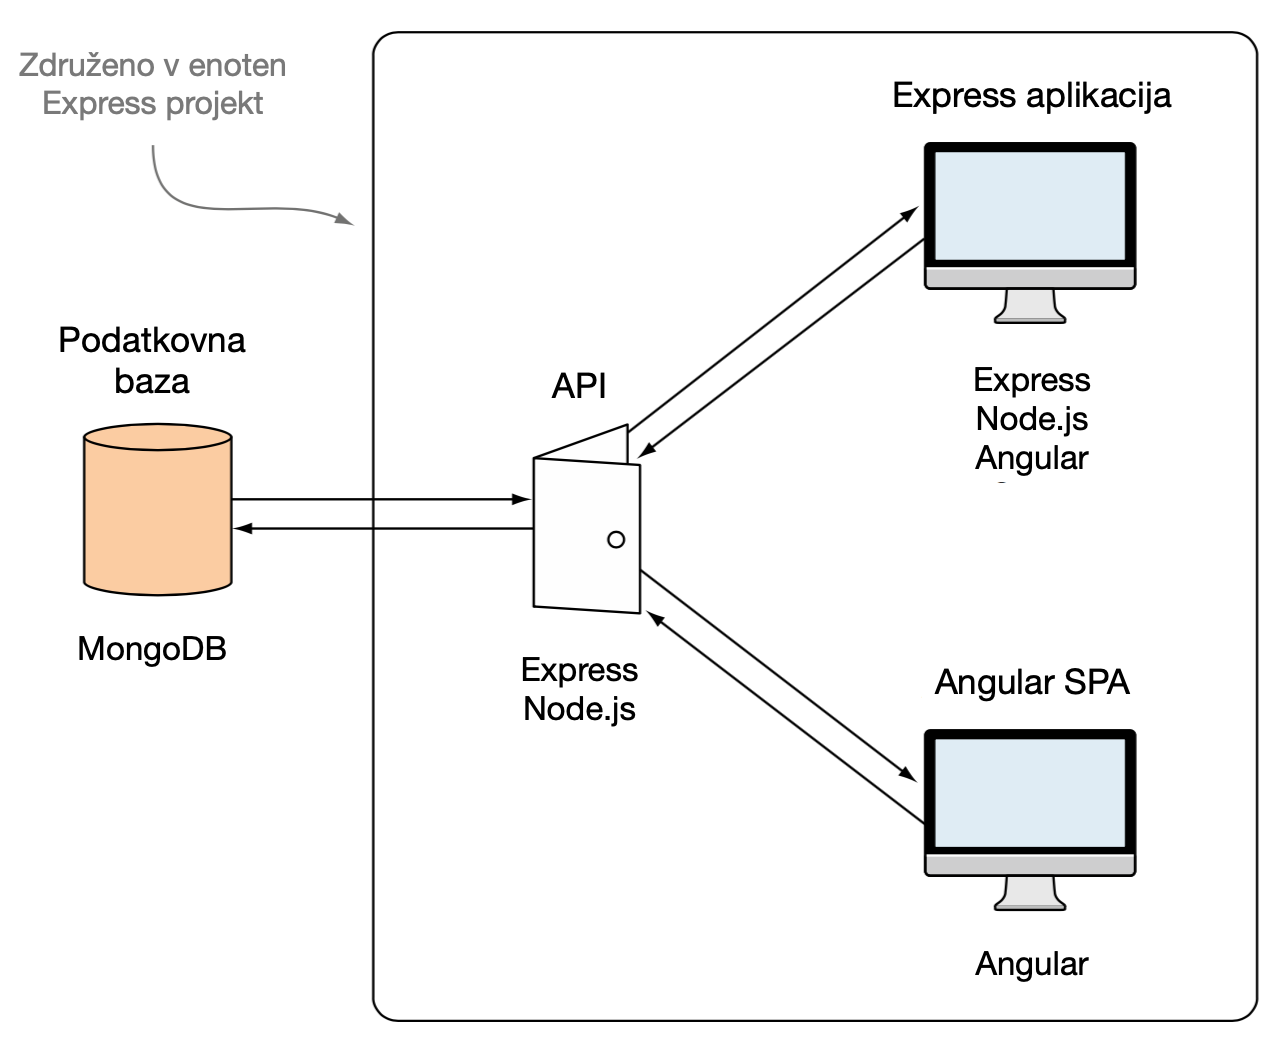
Slika 1.28: Združevanje API logike in aplikacijske logike v enoten Express projekt.
1.6.3 Koraki pri implementaciji nove spletne aplikacije
Pri implementaciji spletne aplikacije bomo uporabili pristop hitrega prototipiranja s koraki, predstavljenimi v nadaljevanju.
1.6.3.1 Izdelava statične spletne strani
Prvi korak je izdelava statične spletne strani, ki predstavlja implementacijo predvidenih zaslonov uporabniškega vmesnika. V okviru tega koraka moramo dejansko zakodirati predhodno pripravljene osnutke zaslonskih mask in potrditi, da so predvideni prehodi med zasloni smiselni. V tem trenutku se še ne ukvarjamo z dinamičnimi podatki iz podatkovne baze, ampak zgolj z izgledom, tako da uporabimo kar vnaprej opredeljene testne primere.
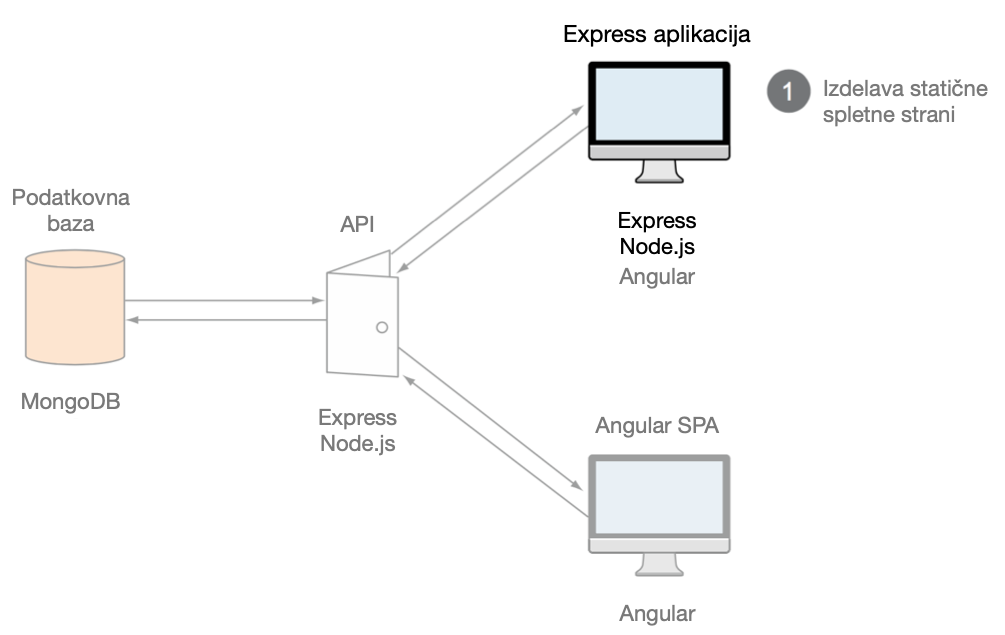
Slika 1.29: Izdelava statične spletne strani.
Z uporabo MEAN arhitekture bomo izdelali statično spletno stran v okolju Node.js ter s pomočjo ogrodja Express, kot to prikazuje slika 1.29.
1.6.3.2 Načrt podatkovnega modela in kreiranje podatkovne baze
Ko imamo na voljo delujoči prototip iz koraka 1, začnemo z zamenjavo statičnih, vnaprej opredeljenih testnih podatkov, tako da našo aplikacijo povežemo s podatkovno bazo. Najprej si moramo zamisliti podatkovni model, ki je skladen z zahtevami aplikacije, nato pa na podlagi tega modela kreiramo podatkovno bazo.
Pri opredelitvi podatkovnega modela moramo identificirati koncepte, ki jih bomo shranjevali v podatkovno bazo. Ker smo v predhodnem koraku že implementirali statični delujoči prototip, je ta del veliko lažji.
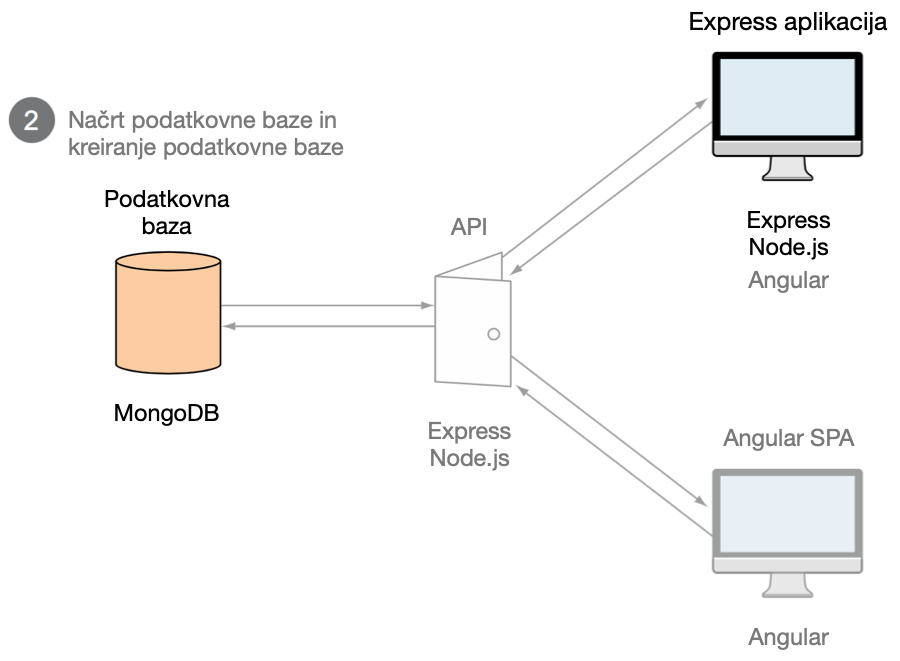
Slika 1.30: Načrt podatkovne baze in kreiranje podatkovne baze.
V našem primeru bomo opredelili shemo podatkovne baze s pomočjo ogrodja Mongoose (LearnBoost 2010) in kreirali MongoDB podatkovno bazo, kot je prikazano na sliki 1.30.
1.6.3.3 Izdelava API vmesnika do podatkovne baze
Do tega koraka imamo na voljo statično spletno stran in podatkovno bazo, zato v tem koraku opredelimo REST API, ki bo naši aplikaciji omogočal interakcijo s podatkovno bazo.
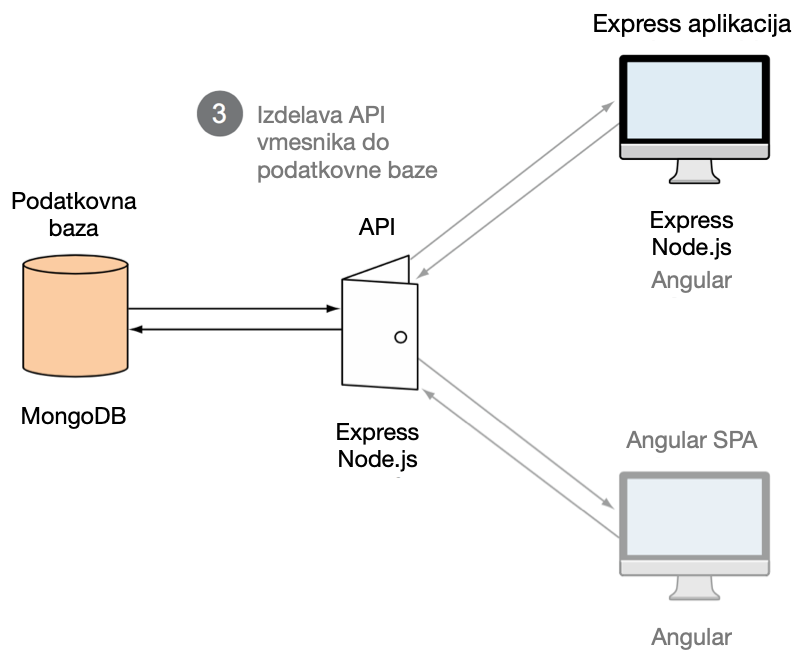
Slika 1.31: Izdelava API vmesnika do podatkovne baze.
Pri implementaciji naše aplikacije bomo REST API vmesnik implementirali s pomočjo Node.js in Express ter si pomagali z ogrodjem Mongoose (LearnBoost 2010), kar je prikazano na sliki 1.31.
1.6.3.4 Povezovanje podatkovne baze z aplikacijo
Statično aplikacijo v tem koraku pretvorimo v dinamično, tako da vključimo dostop do API vmesnika, ki nam omogoča interakcijo s podatkovno bazo.
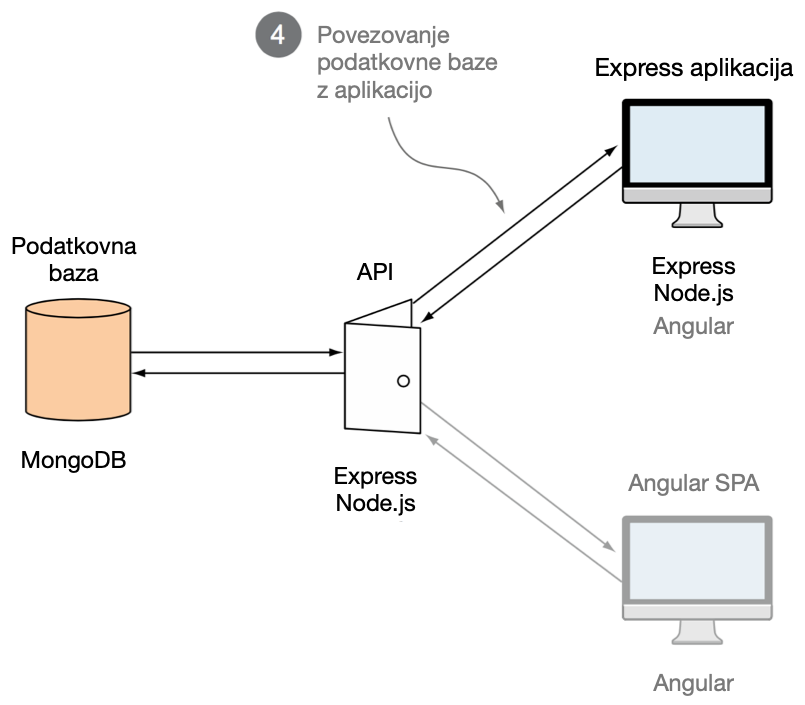
Slika 1.32: Povezovanje podatkovne baze z aplikacijo.
Slika 1.32 prikazuje povezovanje podatkovne baze z aplikacijo, kjer uporabimo za dostop REST API. Po končanem koraku imamo na voljo delujočo aplikacijo v okolju Node.js in Express.
1.6.3.5 Nadgradnja aplikacije
V zaključnem koraku našo aplikacijo izboljšamo, kar lahko pomeni dodajanje ravni avtentikacije uporabnikov, preverjanje podatkov, implementacija metod za prikaz napak idr. Del izboljšave aplikacije je lahko tudi večja stopnja interaktivnosti na uporabniškem vmesniku ali nadgradnja poslovne logike v aplikaciji.
Slika 1.33 prikazuje dodajanje Angular komponent na uporabniški vmesnik z namenom izboljšanja interaktivnosti uporabniške izkušnje.
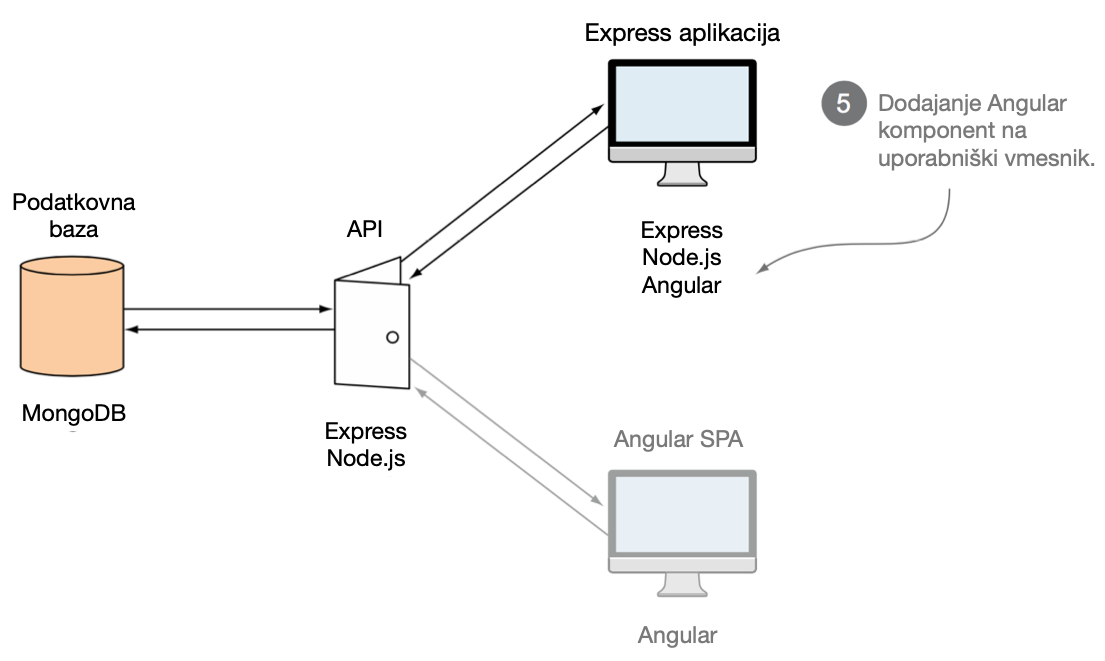
Slika 1.33: Dodajanje Angular komponent na uporabniški vmesnik.
Pri nadgradnji aplikacije bomo preoblikovali obstoječo aplikacijo v Angular SPA aplikacijo na eni strani, kot je prikazano na sliki 1.34. V tem primeru bomo dejansko zamenjali del obstoječe aplikacije, saj bomo del funkcionalnosti prenesli iz strežnika na odjemalca.
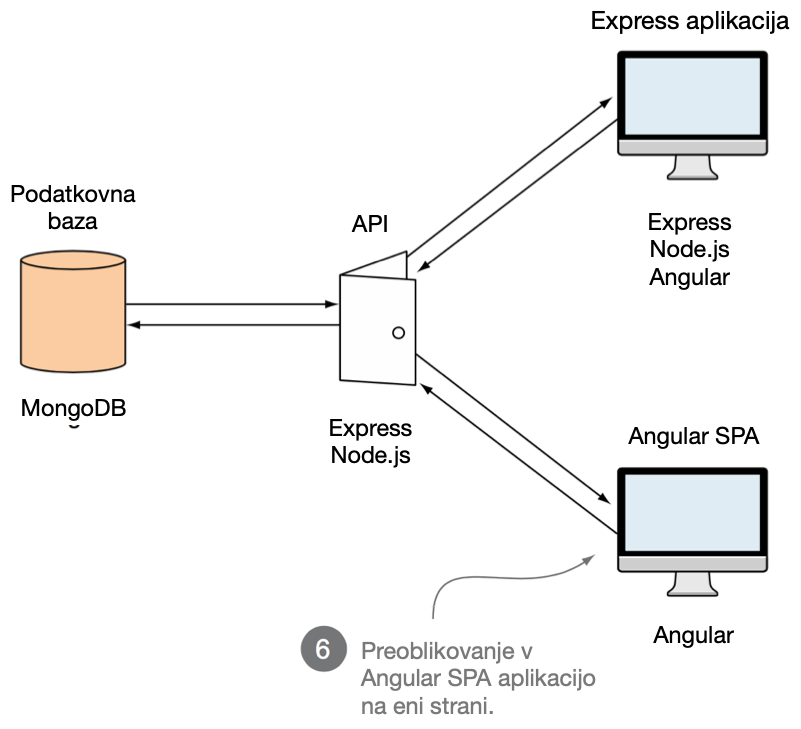
Slika 1.34: Preoblikovanje v Angular SPA aplikacijo na eni strani.
V produkcijskem okolju je pomembna tudi varnost, zato je na sliki 1.35 prikazano dodajanje preverjanja pristnosti uporabnikov s pomočjo MEAN arhitekture, kar vključuje registracijo in prijavo uporabnikov. V okviru preverjanja pristnosti uporabnikov bo dodana tudi varnost na ravni REST API-ja, ki dostopa do podatkov in je na voljo zgolj registriranim uporabnikom. Podatki o uporabnikih bodo shranjeni v podatkovno bazo.
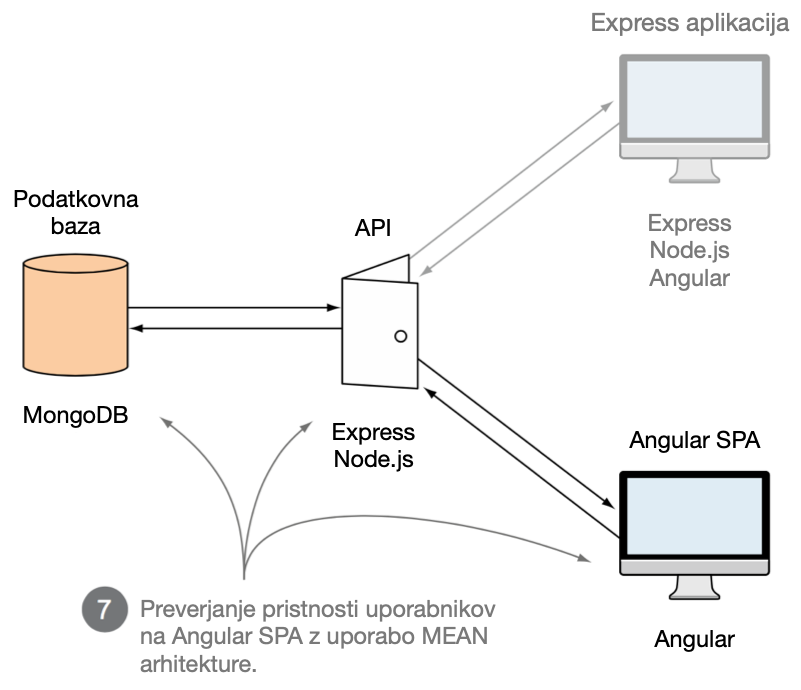
Slika 1.35: Preverjanje pristnosti uporabnikov na Angular SPA z uporabo MEAN arhitekture.
1.7 Okolje
1.7.1 Razvojno okolje
Za razvoj spletnih aplikacij v MEAN arhitekturi je potrebno zgolj namestiti izvajalno okolje za Node.js ter podatkovno bazo MongoDB. Express ogrodje je na voljo kot knjižnica v okolju Node.js, Angular pa se izvaja na strani odjemalca in ga preprosto povlečemo s spletne strani. Omenjene tehnologije lahko namestimo na vseh pogosto uporabljanih platformah, tj. Windows, Mac OSX in večini Linux distribucij. V okviru tečaja si bomo ogledali tudi, kako lahko posamezne elemente naše aplikacije virtualiziramo s pomočjo tehnologije Docker.
1.7.2 Produkcijsko okolje
Produkcijsko okolje se od razvojnega ne razlikuje zelo, gre predvsem za bolj zmogljivo postavitev, ki vsebuje končne, produkcijske različice izvorne kode spletne aplikacije.
Če zahteve aplikacije niso prevelike, lahko imamo najbolj enostavno postavitev v produkciji, kot je prikazano na sliki 1.36 z vsemi komponentami na istem strežniku. Omenjeno postavitev lahko uporabljamo pri majhnem številu uporabnikov, vendar je problematična, ko se začne uporaba aplikacije povečevati.
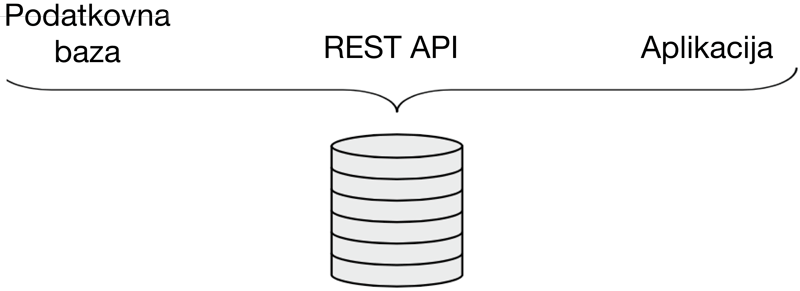
Slika 1.36: Najbolj enostavna postavitev v produkciji, kjer so vse komponente na enem strežniku.
Pri večjih performančnih zahtevah se po navadi izkaže za ozko grlo podatkovna baza, zato je ta komponenta pogosto prvi člen, ki ga namestimo na ločen strežnik, kot to prikazuje slika 1.37. Tudi to je zelo pogost pristop, če uporabljamo PaaS ponudnike, kot jih bomo tudi v našem primeru (Heroku in MongoDB Atlas).
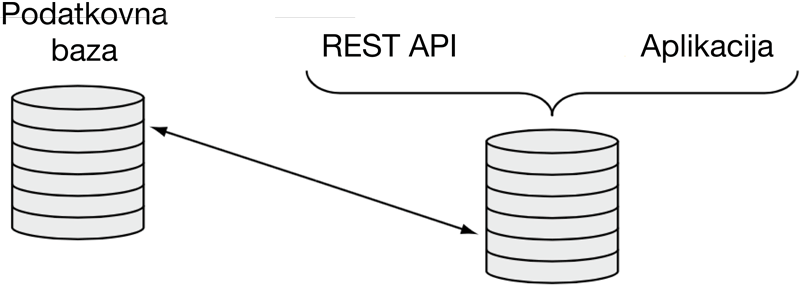
Slika 1.37: Pogosta postavitev v produkciji, kjer je strežnik s podatkovno bazo ločen od strežnika z aplikacijo in API-jem.
Če želimo biti pripravljeni na potencialno rast uporabe naše aplikacije, bomo komponente razdelili tako, da bo vsaka na svojem strežniku, kot to prikazuje slika 1.38.
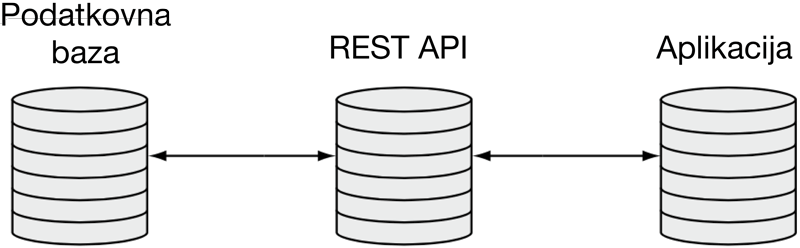
Slika 1.38: V celoti ločena postavitev v produkciji, kjer je vsaka komponenta na svojem strežniku.
S takšno postavitvijo smo pripravljeni tudi na nadaljnje prilagajanje potrebam po posameznih komponentah naše aplikacije, saj lahko skaliramo posamezno komponento, kot je to prikazano na sliki 1.39.
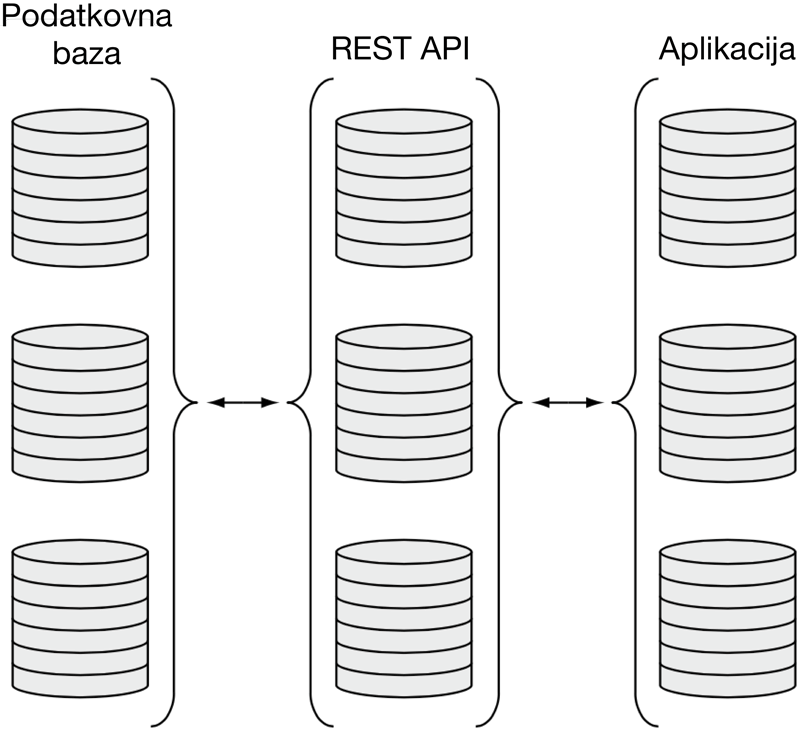
Slika 1.39: Skaliranje MEAN arhitekture z gručenjem strežnikov po posamezni komponenti.
1.8 Git
Sistem za podporo obvladovanju verzij45 (VCS) pomaga akterjem pri razvoju programske opreme pri skupinskem delu in skrbi za arhiviranje celotne zgodovine njihovega dela.
1.8.1 Osnovne operacije VCS
Večina sistemov VCS podpira naslednjih 18 operacij:
create(podrobnosti v poglavju 1.8.1.1),checkout(podrobnosti v poglavju 1.8.1.2),commit(podrobnosti v poglavju 1.8.1.3),update(podrobnosti v poglavju 1.8.1.4),add(podrobnosti v poglavju 1.8.1.5),edit(podrobnosti v poglavju 1.8.1.6),delete(podrobnosti v poglavju 1.8.1.7),rename(podrobnosti v poglavju 1.8.1.8),move(podrobnosti v poglavju 1.8.1.9),status(podrobnosti v poglavju 1.8.1.10),diff(podrobnosti v poglavju 1.8.1.11),revert(podrobnosti v poglavju 1.8.1.12),log(podrobnosti v poglavju 1.8.1.13),tag(podrobnosti v poglavju 1.8.1.14),branch(podrobnosti v poglavju 1.8.1.15),merge(podrobnosti v poglavju 1.8.1.16),resolve(podrobnosti v poglavju 1.8.1.17),lock(podrobnosti v poglavju 1.8.1.18).
1.8.1.2 Checkout
Opomba: DVCS nimajo tega ukaza oz. je identičen
update, kjer se sinhronizira celotno stanje oddaljenega repozitorija, ne zgolj zadnjih popravkov.
Kreiranje nove lokalne delovne kopije iz oddaljenega repozitorija.
Slika 1.41: Operacija checkout
1.8.1.3 Commit
Uveljavljanje sprememb lokalne delovne kopije v repozitorij.
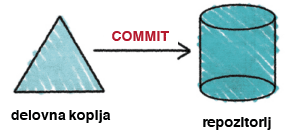
Slika 1.42: Operacija commit
1.8.1.4 Update
Posodobi lokalno delovno verzijo glede na trenutno stanje oddaljenega repozitorija.
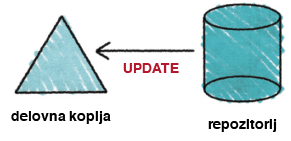
Slika 1.43: Operacija update
1.8.1.6 Edit
Spremeni datoteko v delovni kopiji in je najbolj pogosta operacija.
Slika 1.45: Operacija edit
1.8.1.7 Delete
Izbriše datoteko iz delovne kopije, ki pa ostane za arhiv.
Slika 1.46: Operacija delete
1.8.1.11 Diff
Prikaže podrobnosti izbrane spremembe nad datoteko v delovni kopiji.

Slika 1.50: Operacija diff
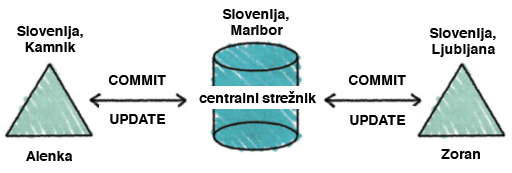
1.8.2 Posebnosti porazdeljenih sistemov za obvladovanje verzij (DVCS)
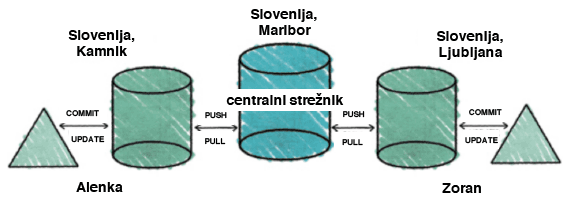
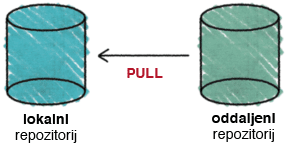
1.8.2.3 Push
Kopiranje sprememb lokalnega repozitorija na oddaljeni repozitorij.
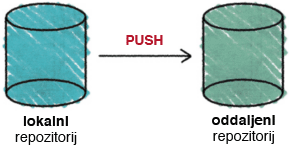
Slika 1.60: Operacija push
1.8.3 Dobre prakse uporabe Git
1.8.3.1 Osrednji repozitorij in sodelovanje med skupinami
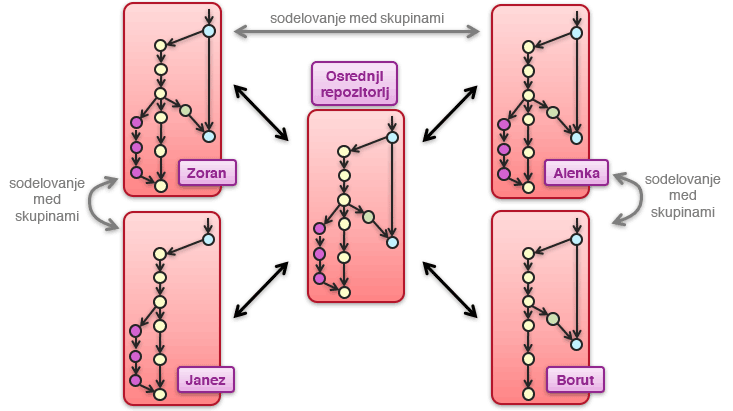
Slika 1.62: Osrednji repozitorij in sodelovanje med skupinami
1.8.3.2 Razdelitev po vejah razvoja
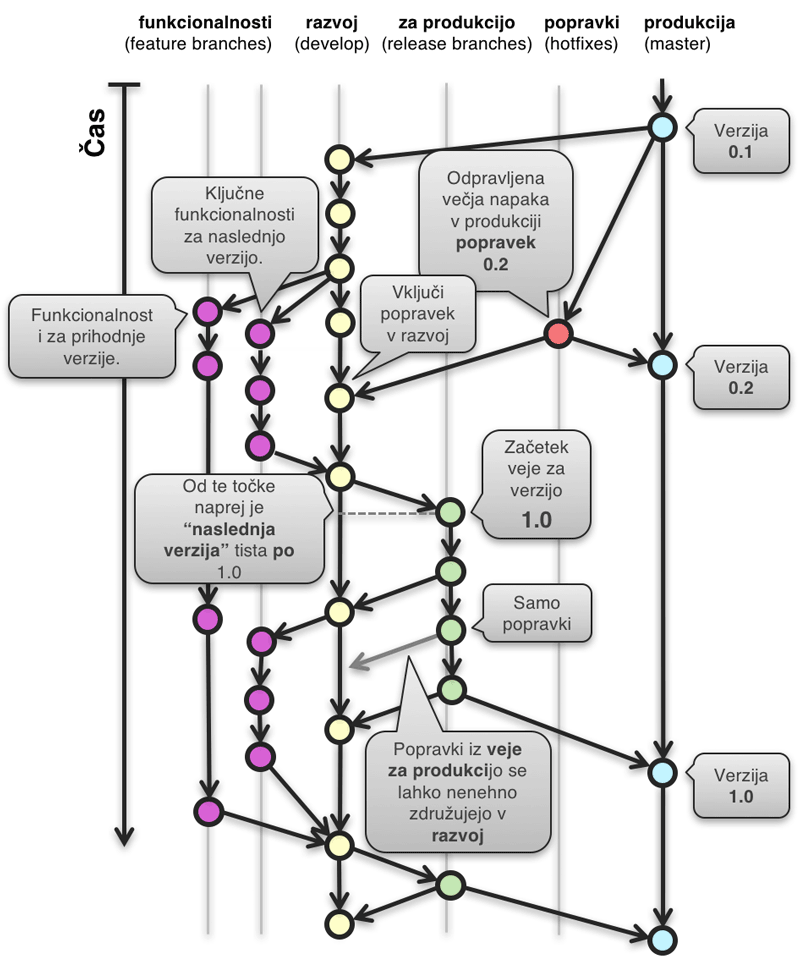
Slika 1.63: Razdelitev po vejah razvoja
1.8.3.2.1 Produkcija (master) in razvoj (develop)
Dobra praksa je opredelitev centralnega repozitorija z naslednjima vejama:
- produkcija (master) in
- tu je vedno na voljo zadnja verzija produkcijske rešitve,
- razvoj (develop),
- ko koda v tej veji razvoja doseže zahtevano stopnjo zrelosti, se združi z master vejo in dobi ustrezno verzijo izdaje.
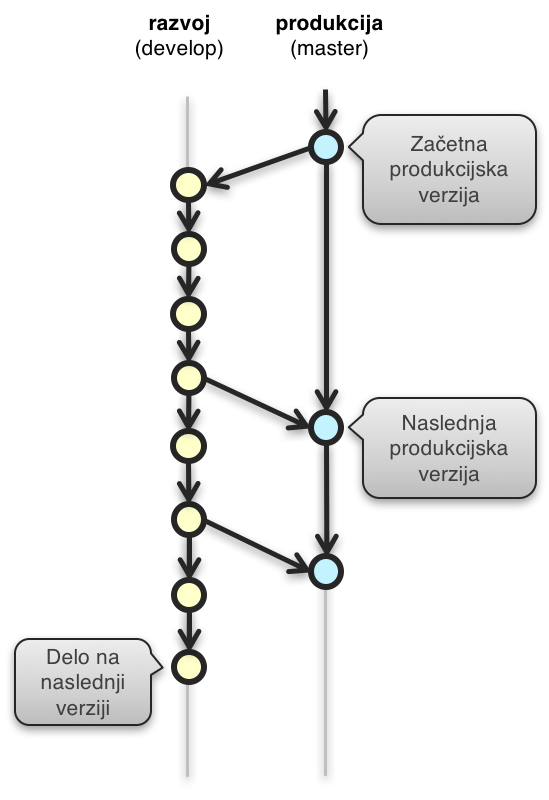
Slika 1.64: Veji razvoja produkcija (master) in razvoj (develop)
1.8.3.2.2 Funkcionalnosti (feature branches)
Priporoča se tudi uporaba naslednje podporne razvojne veje:
- funkcionalnosti (feature branches),
- veja obstaja toliko časa, dokler spremembe niso združene z razvojem (develop),
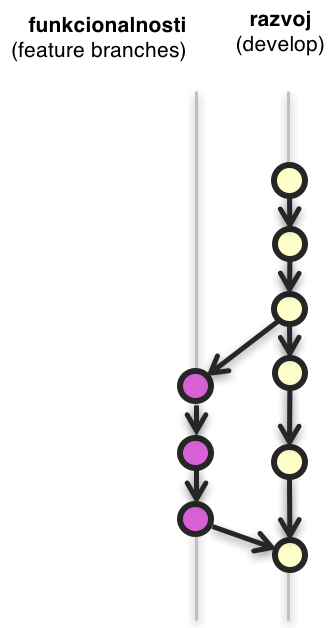
Slika 1.65: Veja razvoja funkcionalnosti (feature branches)
1.8.3.2.3 Za produkcijo (release)
Priporoča se uporaba tudi naslednje podporne razvojne veje:
- za produkcijo (release),
- veja razvoja, ki predstavlja pripravo na izdajo končne verzije.
Kreiranje nove veje razvoja za produkcijo
$ git checkout -b release-1.2
Switched to a new ‘release-1.2’.

$ ./bump-version.sh 1.2
Files modified successfully, version bumped to 1.2.

$ git commit -a -m “Priprava posodobobitve verzije na 1.2”
[release-1.2 74d9424] Priprava posodobitve verzije na 1.2.
1 files changed, 1 insertations(+), 1 deletions(-)1.8.3.2.4 Popravki (hotfix)
Priporoča se uporaba tudi naslednje podporne razvojne veje:
- popravki (hotfix),
- ravno tako so namenjeni pripravi za produkcijo, vendar nenapovedano (napake).
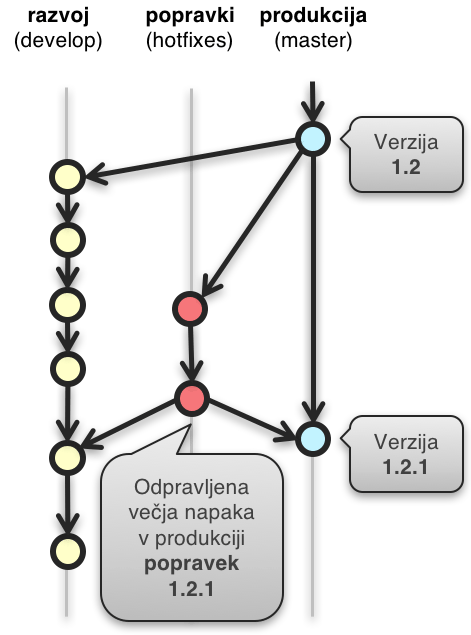
Slika 1.66: Veja razvoja popravki (hotfix)
Kreiranje nove veje popravkov
$ git checkout -b hotfix-1.2.1
Switched to a new ‘hotfix-1.2.1’.

$ ./bump-version.sh 1.2.1
Files modified successfully, version bumped to 1.2.1.

$ git commit -a -m “Priprava posodobobitve verzije na 1.2.1”
[hotfix-1.2.1 41e61bb] Priprava posodobitve verzije na 1.2.1.
1 files changed, 1 insertations(+), 1 deletions(-)Združevanje nazaj v razvoj in brisanje veje s popravki
$ git checkout develop
Switched to branch ‘develop’.

$ git merge --no-ff hotfix-1.2.1
Merge made by recursive.
(Summary of changes)

$ git branch -d hotfix-1.2.1
Deleted branch hotfix-1.2.1 (was abbe5d6).
Dodatno gradivo
|
|
|
|
|
|
angl. World Wide Web (WWW)↩︎
angl. Advanced Research Projects Agency↩︎
angl. packet switching↩︎
angl. Transmission Control Protocol↩︎
angl. Internet Protocol↩︎
angl. HyperText Markup Language↩︎
angl. Hypertext Transfer Protocol↩︎
angl. Uniform Resource Locator↩︎
angl. HyperText Transfer Protocol Secure↩︎
angl. Secure Sockets Layer↩︎
angl. Transport Layer Security↩︎
angl. Uniform Resource Identifier↩︎
angl. Uniform Resource Locator↩︎
angl. hostname↩︎
angl. Domain Name System↩︎
angl. port↩︎
angl. header↩︎
angl. Multipurpose Internet Mail Extensions↩︎
angl. cache↩︎
angl. Multitier Architecture↩︎
angl. recommendations↩︎
angl. Web 2.0↩︎
angl. Web 1.0↩︎
angl. collective intelligence↩︎
angl. Web Services↩︎
angl. mashup↩︎
angl. Asynchronous JavaScript And Xml↩︎
angl. Semantic Web↩︎
angl. Web 3.0↩︎
angl. Web of Data↩︎
angl. Web3↩︎
angl. Create Read Update Delete↩︎
angl. full-stack development↩︎
angl. back end↩︎
angl. crowdsourcing↩︎
angl. multithreaded↩︎
angl. non SQL↩︎
angl. Binary JSON (JavaScript Serialized Object Notation)↩︎
angl. JavaScript Serialized Object Notation↩︎
angl. Application Program Interface↩︎
angl. Single Page Application (SPA)↩︎
angl. REpresentational State Transfer↩︎
angl. Version Control System (VCS)↩︎